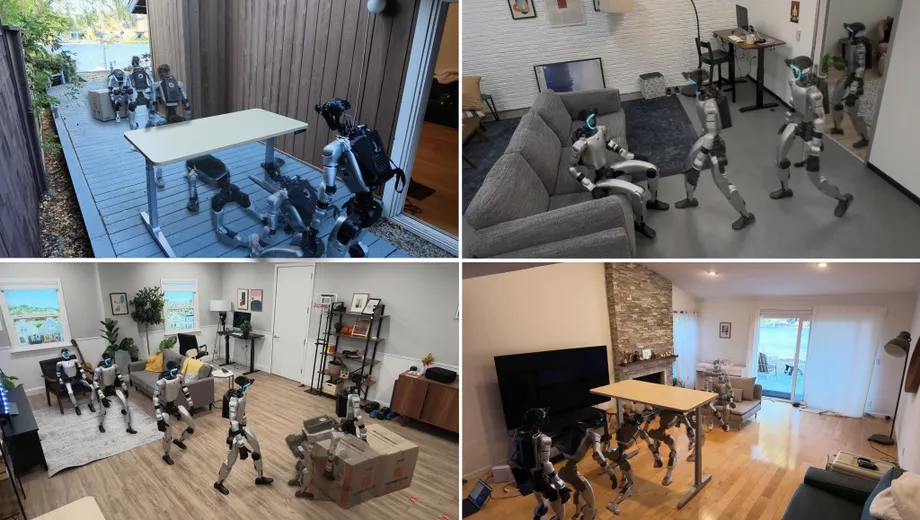
Un robot entrenado en hogares virtuales se enfrenta a habitaciones reales
Investigadores de Apple afirman que su sistema de control humanoide HALO completó tareas físicas individuales con una tasa media de éxito del 91% en 360 pruebas realizadas en seis entornos reales que nunca se habían escaneado ni cartografiado. El sistema, instalado en un Unitree Robotics G1, aplicó lo aprendido en simulaciones para desplazarse por espacios desconocidos, sentarse en muebles, pasar por aberturas estrechas y empujar cajas.
Contenido
- Un robot entrenado en hogares virtuales se enfrenta a habitaciones reales
- Qué abarca el resultado del 91%
- Por qué las instrucciones más largas son más difíciles
- Tres capas convierten una petición en movimiento
- Una Mac mini viaja sobre el G1
- Cómo 1.000 hogares virtuales aportan ejemplos de entrenamiento
- El costo informático y el trabajo humano
- La visión todavía no resuelve el contacto
- Qué cambia con esta investigación
- Puntos clave
Los resultados aparecen en Perceptive Humanoid Motion from Simulation, presentado en arXiv el 4 de noviembre de 2026. El artículo del equipo de Apple describe un entrenamiento con unas 300 horas de ejemplos sintéticos en 1.000 entornos domésticos generados por computadora y la transferencia directa del sistema a un robot físico.
Las tareas más largas resultaron más difíciles. En otro entorno real, HALO logró una media de éxito del 70% en tres secuencias de acciones, cada una probada 10 veces. La secuencia en la que debía agacharse para pasar bajo un obstáculo, acercarse a un objetivo y empujar una caja tuvo éxito en cinco de los 10 intentos.
El avance práctico consiste en vincular la comprensión de una petición con el movimiento de todo el cuerpo en espacios con muebles desconocidos. Una orden como sentarse en una silla exige que el robot identifique el asiento, encuentre una ruta, coloque el cuerpo en la posición adecuada y mantenga el equilibrio mientras se sienta. HALO distribuye estas responsabilidades entre tres capas de control que trabajan en conjunto.
Los autores son Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller y Vladlen Koltun, todos afiliados a Apple. También publicaron código que abarca la generación de datos, el entrenamiento y la implementación, incluida la planificación de tareas, la generación de movimientos y el seguimiento de movimientos en simulaciones y robots físicos.
Qué abarca el resultado del 91%
Las tasas de éxito variaron entre las seis habilidades individuales. Agacharse obtuvo el mejor resultado, mientras que sentarse fue la acción menos exitosa de las probadas:
- Ir hacia un objeto indicado: 92%.
- Sentarse en un mueble: 85%.
- Pasar por una puerta parcialmente abierta: 93%.
- Agacharse para pasar bajo un obstáculo: 100%.
- Gatear para pasar bajo un obstáculo: 90%.
- Empujar una caja: 88%.
La diferencia entre agacharse y sentarse fue de 15 puntos porcentuales. Sentarse implica más que llegar al lugar correcto: el robot debe alinearse con el mueble y apoyar su peso sobre el asiento. Esto exige tanto capacidad de comprensión visual como control físico.
Los seis entornos de evaluación eran desconocidos para HALO. Los investigadores no los habían escaneado previamente ni los habían utilizado durante el entrenamiento. El artículo denomina a este proceso transferencia de cero disparos: el sistema pasó del entrenamiento simulado a esos entornos físicos sin recibir entrenamiento adicional para cada lugar.
Las demostraciones también muestran al G1 siguiendo a una persona, sentándose en un sofá, desplazándose de lado por una puerta parcialmente abierta y agachándose o gateando bajo una mesa. Estos movimientos ilustran cómo el sistema adapta su postura al espacio que lo rodea, en lugar de limitarse a caminar hacia un destino.
Por qué las instrucciones más largas son más difíciles
Las tres secuencias de tareas de HALO produjeron resultados más dispares. Pasar por una puerta y luego ir hacia un objetivo tuvo éxito en las 10 pruebas. Agacharse y luego sentarse tuvo éxito en seis. Agacharse, acercarse a un objetivo y empujar una caja tuvo éxito en cinco.
En conjunto, esos resultados equivalen a 21 secuencias exitosas de 30 intentos, es decir, un 70%. La cifra está 21 puntos porcentuales por debajo de la media de las tareas individuales, aunque las pruebas de secuencias se realizaron en otro entorno y con menos intentos.
Una secuencia ofrece más oportunidades para que algo falle porque el resultado de un movimiento determina la posición inicial del siguiente. Por ejemplo, al salir de debajo de un obstáculo, el robot debe quedar en una posición que le permita acercarse al objetivo y realizar el movimiento siguiente.
HALO aborda este problema mediante comprobaciones visuales. Su planificador analiza el video desde la perspectiva del robot, evalúa si la acción actual tuvo éxito y decide si debe continuar o intentarlo de nuevo. Los resultados muestran que enlazar habilidades útiles sigue siendo más exigente que realizarlas por separado.
Tres capas convierten una petición en movimiento
La capa de control superior se encarga de planificar las tareas. Utiliza un modelo de visión y lenguaje, un tipo de IA que procesa imágenes y palabras, para interpretar una petición junto con lo que capta la cámara. El modelo predeterminado es Qwen3.6-35B-A3B, que funciona localmente en una Mac mini transportada por el robot.
El planificador se activa cada dos segundos. Si alguien pide al robot que se siente sin especificar en qué asiento, este debe elegir un objeto adecuado que esté a la vista. Si una mesa bloquea el camino hacia una silla, puede dividir la petición en acciones más pequeñas: agacharse para pasar bajo el obstáculo, acercarse a la silla y sentarse.
La capa intermedia convierte cada subtarea en un plan de movimiento. Combina Qwen3.5-2B, cuyos parámetros del codificador permanecen fijos durante el entrenamiento, con un decodificador transformador de difusión que genera movimientos de todo el cuerpo. Un codificador transforma la imagen y la instrucción en una representación que el modelo de movimiento puede utilizar; el decodificador produce las posturas previstas.
Esta capa planifica aproximadamente cinco segundos por adelantado y vuelve a calcular el plan unas tres veces por segundo. Así, actualiza continuamente el movimiento previsto a partir de nuevas imágenes de la cámara, en lugar de comprometerse a ejecutar una acción completa de cinco segundos sin comprobar el entorno.
La capa inferior, denominada seguidor de movimiento, convierte esos planes en órdenes para las articulaciones 50 veces por segundo. Combina imágenes de profundidad con información sobre la posición y el movimiento del propio robot, lo que le ayuda a seguir el plan teniendo en cuenta el equilibrio, el contacto y los límites de los motores.
Una Mac mini viaja sobre el G1
La configuración física incluye una Mac mini con un chip M4 Pro y 64 GB de memoria unificada dentro de una carcasa protectora en la espalda del G1. Ese equipo ejecuta los modelos más exigentes de planificación de tareas y generación de movimientos. El procesador integrado del G1 se encarga del seguidor de movimiento.
Un soporte personalizado en la cabeza lleva una cámara OAK-1W. Su señal de video en color tiene una resolución de 1280 por 800 píxeles, funciona a 30 fotogramas por segundo y abarca un campo de visión de 120 grados. La amplitud de la imagen ayuda al sistema a observar los muebles y las aberturas cercanas mientras el cuerpo se mueve.
El robot funciona sin cables y sus componentes de software se comunican mediante ZeroMQ, un sistema de mensajería. La configuración local predeterminada puede funcionar sin conexión a Internet. HALO también puede recurrir a un modelo en la nube mediante una interfaz de programación de aplicaciones cuando se configura para ello.
La distribución del trabajo informático se ajusta a la jerarquía de control. La comprensión de una petición puede realizarse con menos frecuencia, mientras que mantener estable un robot en movimiento requiere actualizaciones mucho más rápidas. El generador de movimientos calcula un nuevo plan mientras el seguidor ejecuta el actual, lo que evita que el robot se detenga cada vez que el modelo necesita hacer cálculos.
Cómo 1.000 hogares virtuales aportan ejemplos de entrenamiento
El proceso de entrenamiento de HALO aborda una escasez concreta: ejemplos que vinculen lo que ve un humanoide, lo que se le pide hacer y cómo debe moverse todo su cuerpo. Los videos comunes contienen imágenes de acciones, pero para entrenar este sistema es necesario emparejar esas imágenes con instrucciones y movimientos detallados del robot.
Los autores describen el tiempo que requieren algunos métodos que recopilan demostraciones mediante el manejo humano o dispositivos de grabación portátiles:
«Como una persona debe realizar manualmente cada episodio, una hora de datos cuesta al menos una hora de trabajo humano».
En cambio, HALO crea ejemplos emparejados mediante simulaciones. El proceso comienza con una tarea dividida en segmentos de movimiento. Sentarse en un sillón, por ejemplo, puede implicar caminar hacia delante, darse la vuelta y bajar hasta el asiento. Indicaciones de texto, puntos de referencia de la ruta y posturas clave orientan un modelo de generación de movimientos llamado Kimodo.
Luego, comprobaciones geométricas automatizadas califican los movimientos candidatos en función de problemas como el deslizamiento de los pies, los cuerpos que atraviesan el suelo, los saltos bruscos y las articulaciones que superan sus límites. El proceso selecciona la mejor opción antes de situar el movimiento en una habitación virtual.
Infinigen, un generador procedimental de escenas, proporciona 1.000 entornos con distribuciones y muebles variados, incluidos salones, oficinas y dormitorios. El sistema busca ubicaciones donde el movimiento previsto del robot y el objeto objetivo encajen sin chocar con los muebles circundantes.
Después, un simulador genera imágenes de lo que vería el robot al realizar la acción, mediante una cámara de ojo de pez simulada que reproduce la configuración física. Las variaciones de iluminación, exposición, color, contraste, desenfoque y ruido del sensor aumentan la diversidad de las imágenes. Cada ejemplo resultante vincula una instrucción, una imagen de la cámara y el movimiento corporal correspondiente.
El costo informático y el trabajo humano
La generación del conjunto principal de datos de entrenamiento tomó unas 48 horas con 250 procesadores gráficos Nvidia H100. Estos procesadores, conocidos como GPU, realizan muchos cálculos en paralelo, lo que permite generar grandes cantidades de datos simulados a la vez.
El generador de acciones se entrenó mediante aprendizaje por imitación con 64 GPU Nvidia B200. En el aprendizaje por imitación, un modelo aprende a reproducir ejemplos de comportamiento. El seguidor de movimiento se entrenó con cuatro GPU H100 mediante una combinación de aprendizaje por refuerzo y destilación de políticas.
El aprendizaje por refuerzo entrena un controlador mediante intentos y comentarios sobre su rendimiento. La destilación de políticas transfiere el comportamiento aprendido a otro modelo. En HALO, estos métodos ayudan al seguidor a convertir las posturas previstas en movimientos que el robot físico puede ejecutar.
Las personas siguen definiendo algunas partes del proceso. Añadir una nueva tarea física requiere redactar indicaciones y diseñar posturas clave, y algunos movimientos se basan en videos humanos o material de captura de movimiento. Una vez que existen esas descripciones y restricciones, el proceso puede reutilizarlas en muchas habitaciones generadas.
El cambio, por tanto, está en la forma de ampliar las demostraciones. En lugar de pedir a una persona que realice cada episodio, HALO utiliza recursos informáticos para generar y comprobar muchas variaciones de una tarea.
La visión todavía no resuelve el contacto
Según los investigadores, HALO depende principalmente de la visión y no puede percibir directamente el contacto. El rendimiento puede disminuir en tareas con un contacto físico considerable cuando un objeto sale del campo de visión de la cámara o queda oculto detrás de otro elemento.
Empujar una caja ilustra la importancia de esto. El robot debe mantener la posición correcta de su cuerpo con respecto a la caja mientras ambos se mueven. Una cámara puede proporcionar información sobre la posición visible, mientras que el sentido del tacto podría aportar información sobre el contacto, útil incluso cuando la visión está bloqueada.
Los investigadores señalan la percepción táctil como una posible línea de trabajo futuro, aunque no indican cuándo podría incorporarse. Los resultados actuales delimitan el desafío: HALO puede realizar varias habilidades guiadas visualmente en habitaciones desconocidas, pero las secuencias más largas y las interacciones con contacto siguen siendo menos fiables.
Qué cambia con esta investigación
El estudio de Apple reúne en un mismo sistema la generación de datos de entrenamiento, la planificación basada en el lenguaje y el control físico. El sistema funciona en un humanoide dentro de habitaciones que no había encontrado antes. Su resultado más destacado es la transferencia de 1.000 entornos simulados a 360 pruebas físicas sin cartografiar previamente los seis lugares de evaluación.
El código publicado permite utilizar el proceso en futuras investigaciones, tanto en simulaciones como en hardware. Incluye los mecanismos para producir ejemplos de entrenamiento, así como los modelos y programas necesarios para generar, seguir y coordinar movimientos.
Para una persona que pide a un robot que se siente o mueva una caja, la fiabilidad depende de que funcione toda la cadena: reconocer el objeto adecuado, llegar hasta él, establecer contacto y completar el movimiento. Los resultados de HALO en tareas individuales muestran avances en esa cadena. Los resultados de las secuencias señalan dónde se necesita más trabajo antes de poder combinar varias acciones con la misma consistencia.
Puntos clave
- Investigadores de Apple presentaron Perceptive Humanoid Motion from Simulation en arXiv el 4 de noviembre de 2026.
- HALO logró una tasa media de éxito del 91% en 360 pruebas de tareas individuales realizadas en seis entornos reales desconocidos y sin cartografiar.
- Tres secuencias de tareas alcanzaron una media de éxito del 70% en 30 pruebas realizadas en otro entorno real.
- El sistema combina la planificación de tareas, la generación de movimientos y un seguidor que envía órdenes a las articulaciones 50 veces por segundo.
- El entrenamiento utilizó unas 300 horas de ejemplos sintéticos en 1.000 entornos generados.
- Una Mac mini transportada por el Unitree G1 permite el funcionamiento local sin conexión a Internet.
- El diseño humano de tareas sigue siendo parte del entrenamiento, y la capacidad limitada para percibir el contacto continúa siendo una debilidad.