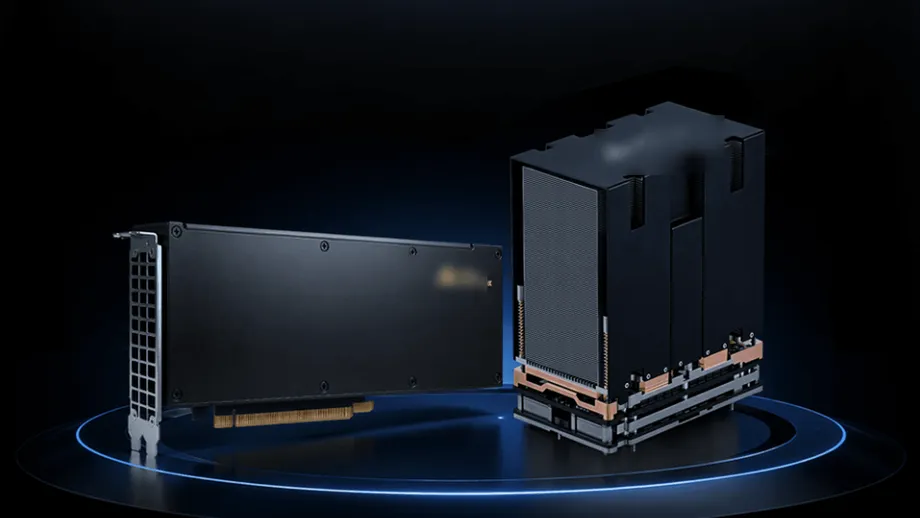
Una GPU funcional y una afirmación de un 5% más de rendimiento
Iluvatar CoreX presentó públicamente su procesador gráfico Tiangai 300 en Shanghái y lo mostró como una alternativa china a la H200 de Nvidia, con una ventaja declarada del 5% en una prueba de inferencia realizada por un tercero. En su jornada de puertas abiertas para los medios del 28 de octubre de 2026, la empresa también presentó un sistema de entrenamiento con ocho GPU y describió un rack con 144 GPU y 18 CPU.
Contenido
- Una GPU funcional y una afirmación de un 5% más de rendimiento
- Qué mide la comparación con la H200
- Documentos largos y respuestas iniciales más rápidas
- Los resultados de entrenamiento usan otra referencia de Nvidia
- Del lanzamiento de julio a la demostración de octubre
- Un rack con 144 GPU
- Repartir el trabajo de IA entre distintos chips
- Las afirmaciones sobre el software apuntan a reducir los plazos de implementación
- La TY1200 amplía la propuesta a los robots
- Puntos clave
La comparación destacada se basa en pruebas que Shanghai Electric Group completó en julio, según Iluvatar CoreX. En una implementación que separó dos etapas del procesamiento de modelos de lenguaje grandes, la Tiangai 300 alcanzó un rendimiento total equivalente a 1,05 veces el de una H200, una vez convertidos los resultados a una cifra por tarjeta.
El rendimiento se refiere a la cantidad de trabajo útil que un sistema completa en un tiempo determinado. En un chatbot, puede significar cuántos fragmentos de texto genera por segundo. Un resultado de 1,05 veces el rendimiento de referencia significa un 5% más de producción en las condiciones de esa prueba.
La empresa describió la Tiangai 300 como la primera GPU china de propósito general que alcanza el rendimiento de la H200 en pruebas medidas. En su demostración de octubre amplió la comparación a modelos de lenguaje, generación de imágenes y generación de video, mientras que en una demostración de entrenamiento aparte tomó la H100 de Nvidia como referencia.
El evento presentó mucho más que las especificaciones de un chip. Iluvatar CoreX mostró tarjetas, servidores, un diseño de rack de alta densidad, herramientas de software y un método para repartir tareas de IA entre distintos tipos de procesadores. Su propuesta comercial es que estos componentes pueden generar resultados útiles de IA a menor costo y con menos espera.
Qué mide la comparación con la H200
La prueba de julio de Shanghai Electric Group utilizó la separación entre prellenado y decodificación, conocida a menudo como separación PD. El prellenado es la etapa en la que un modelo de lenguaje lee la solicitud del usuario y el material de apoyo. La decodificación es la etapa en la que genera una respuesta, un token a la vez. Los tokens son las unidades pequeñas en las que los sistemas de IA dividen el texto.
Separar esas etapas permite asignar recursos de forma distinta a la lectura y la escritura. Por tanto, el resultado de la Tiangai 300 corresponde a una configuración de implementación específica, con el rendimiento total expresado como una cifra equivalente por tarjeta.
Iluvatar CoreX no había publicado el método detallado de la prueba, la lista de modelos ni las condiciones de carga de trabajo que sustentan el resultado destacado de la prueba de terceros. Esos detalles, junto con el cálculo de conversión y la configuración del software, son necesarios para reproducirla de manera independiente. Tampoco se ha publicado un desglose de la comparación de costos, y es necesario aclarar las cifras de memoria de cada tarjeta y del rack completo.
Las demostraciones identificadas por el laboratorio de rendimiento ofrecen una visión más detallada de las afirmaciones de la empresa. Describen mejoras distintas según la tarea, desde un pequeño aumento en la generación multimedia hasta un mayor incremento del rendimiento de recomendación. Para un comprador, la comparación pertinente es la tarea que realiza su propio servicio.
Documentos largos y respuestas iniciales más rápidas
Según el laboratorio de la empresa, el rendimiento de atención de la Tiangai 300 alcanzó 1,05 veces el de la H200 con una longitud de contexto de 64K. La atención es el proceso que ayuda a un modelo a determinar qué partes de la entrada están relacionadas entre sí. Una longitud de contexto de 64K significa que el modelo procesa alrededor de 64.000 tokens.
Con GLM-5.3 y la misma escala de contexto, Iluvatar CoreX afirmó que el rendimiento era 1,15 veces el de la H200, manteniendo una experiencia de usuario equivalente. Esto supone un aumento del 15% para la carga de trabajo de mezcla de expertos probada. Un modelo de mezcla de expertos dirige el trabajo a redes especializadas seleccionadas, en lugar de utilizar todas las redes para cada token.
Para las cargas de trabajo de agentes de IA con contextos de entre 8K y 128K, la empresa informó de una reducción de alrededor del 10% al 30% en la espera hasta el primer token de salida. Esta medida es importante para quien espera a que un asistente empiece a responder después de leer un documento largo o procesar una solicitud compleja.
La generación de imágenes y video también formó parte de la demostración. La empresa informó de un aumento de alrededor del 2% al 5% en el rendimiento de generación multimodal frente a la H200. En cargas de trabajo de búsqueda en línea, publicidad y recomendación, afirmó que el rendimiento de inferencia de recomendación era un 21% mayor y la latencia de los cálculos ligeros, un 26% menor.
Los resultados de entrenamiento usan otra referencia de Nvidia
La demostración de entrenamiento utilizó Qwen3-32B, un modelo con aproximadamente 32.000 millones de parámetros, en un servidor con ocho GPU. Los parámetros son los valores numéricos que un modelo ajusta durante el entrenamiento para aprender patrones. Iluvatar CoreX afirmó que el rendimiento efectivo por tarjeta alcanzó 1,33 veces el de la H100 de Nvidia.
Por tanto, la ventaja declarada fue del 33% en esa demostración de entrenamiento, tomando como referencia el chip H100. En cambio, los resultados de inferencia presentados en otras partes del evento usaron la H200. Es fundamental mantener separados estos productos de referencia para entender las cifras.
El sistema de entrenamiento funcionó con precisión FP8. FP8 almacena números en ocho bits, lo que reduce la cantidad de datos que deben transferirse y procesarse en comparación con los formatos que usan más bits. El software de entrenamiento de IA debe gestionar cuidadosamente esa menor precisión para preservar la calidad del aprendizaje.
Iluvatar CoreX también informó de una variación del tiempo por paso del 0,43% durante un funcionamiento prolongado a plena carga, frente al 0,76% de un sistema de referencia basado en Hopper. El tiempo por paso es el tiempo necesario para completar una unidad de trabajo repetida. Una mayor regularidad en los tiempos puede ayudar a los operadores a calcular cuánto trabajo completará un sistema con mucha actividad.
Del lanzamiento de julio a la demostración de octubre
La Tiangai 300 se presentó oficialmente en la Conferencia Mundial de Inteligencia Artificial en julio de 2026. Utiliza la arquitectura Tianshu de la empresa, incorpora una nueva generación de Tensor Cores y tiene una memoria gráfica especificada de 144 GB.
El procesador admite operaciones escalares, vectoriales y tensoriales. En términos sencillos, estas operaciones se ocupan de números individuales, grupos de números y matrices matemáticas de mayor tamaño. Los formatos numéricos admitidos incluyen FP4, FP8, FP16 y BF16, lo que ofrece a los desarrolladores de software distintas opciones de velocidad, uso de memoria y precisión numérica.
Los hitos públicos descritos por la empresa abarcan varios meses:
- Julio de 2026: la Tiangai 300 se presentó en la Conferencia Mundial de Inteligencia Artificial.
- Julio de 2026: Shanghai Electric Group completó la prueba de terceros citada para la comparación del rendimiento con la H200.
- Antes del evento para los medios de octubre: el diseño del rack IXL144 se presentó en la Feria Internacional de la Industria de China.
- 28 de octubre de 2026: Iluvatar CoreX abrió a los medios, en Shanghái, las demostraciones en vivo del hardware Tiangai 300.
El evento de octubre trasladó la presentación del producto de las explicaciones sobre arquitectura a sistemas que ejecutaban cargas de trabajo identificadas. La gama de implementaciones descrita por la empresa abarca ahora desde tarjetas aceleradoras individuales hasta servidores con ocho tarjetas y el sistema IXL144 de mayor tamaño.
Un rack con 144 GPU
El IXL144 integra 144 GPU y 18 CPU en un rack estándar, con aproximadamente 10,1 TB de memoria GPU total, según Iluvatar CoreX. La empresa lo describió como el supernodo GPU de mayor densidad de la industria alojado en un solo rack. Un supernodo conecta estrechamente muchos procesadores para que puedan colaborar en tareas de gran escala.
La especificación declarada de 144 GB por Tiangai 300 y los 10,1 TB totales indicados para el rack requieren un desglose más claro de la configuración. Multiplicar 144 tarjetas por 144 GB da 20.736 GB, antes de considerar las diferencias en la forma de contabilizar la capacidad. La descripción del rack debe especificar la configuración de las tarjetas y la capacidad de memoria disponible para las cargas de trabajo.
Iluvatar CoreX calcula que el sistema puede reducir alrededor de un 40% el costo por millón de tokens efectivos frente a los sistemas internacionales convencionales. Los tokens efectivos son los que se contabilizan como trabajo útil. Para los operadores que venden servicios de IA, esta medida relaciona el gasto en hardware con la cantidad de resultados aprovechables que produce.
Una reducción del 40% supondría un costo de 60 unidades para un trabajo que cuesta 100 unidades en el sistema de referencia. El ahorro real dependerá del precio del equipo, el consumo eléctrico, el software, la carga de trabajo y la regularidad con que se mantengan ocupadas las GPU.
La empresa también describió un objetivo para su motor de interconexión entre pares de próxima generación: reducir de entre 3 y 5 microsegundos a 1 microsegundo una transferencia dentro del dominio conectado. Una comunicación más rápida ayuda cuando distintas GPU almacenan diferentes partes de un modelo y deben intercambiar datos repetidamente.
Repartir el trabajo de IA entre distintos chips
El enfoque de implementación heterogénea de Iluvatar CoreX asigna distintas partes de la inferencia a diferentes tipos de procesadores. En su esquema de separación AFD, la Tiangai 300 se encarga de toda la etapa de prellenado y de los cálculos de atención durante la decodificación. La XPU de un socio procesa las redes expertas de propagación hacia delante.
XPU es un término amplio para referirse a otro tipo de acelerador informático. La idea de fondo es asignar a cada procesador el trabajo que mejor realiza, mientras un planificador común coordina toda la tarea. Las redes de propagación hacia delante llevan a cabo otra parte importante del procesamiento matemático dentro de un modelo de lenguaje.
La empresa informó de una reducción del 60% en la latencia de inferencia durante la decodificación con una planificación unificada. Se trata de una configuración de sistema distinta a la ventaja de rendimiento del 5% frente a la H200, y utiliza otra medida de rendimiento.
Shan Tianyi, responsable de IA y computación acelerada de la empresa, afirmó que los futuros sistemas de computación para IA dependerán de organizar distintos chips de manera eficiente, en lugar de recurrir a un solo tipo de procesador para todas las tareas. La demostración AFD lleva esa estrategia a una configuración concreta de GPU y aceleradores de socios.
Las afirmaciones sobre el software apuntan a reducir los plazos de implementación
Iluvatar CoreX también presentó una plataforma de software de IA para IA, destinada a automatizar partes de la implementación y la optimización. La empresa afirmó que una tarea de configuración del entorno pasó de una hora a 10 minutos, mientras que las operaciones manuales se redujeron de varias decenas a una.
Para una tarea de optimización de un modelo grande, la empresa informó que redujo el ciclo de trabajo de siete días a menos de dos horas, con un rendimiento cercano al doble del nivel anterior. Estos ejemplos se refieren al trabajo de ingeniería necesario para ejecutar modelos de manera eficiente en el hardware.
La empresa también afirmó que cuenta con una integración profunda con FlyDSL, un lenguaje para desarrollar rutinas de cálculo en GPU. Indicó que la velocidad de compilación mejoró más del 90% y describió un proceso de trabajo que antes requería que 10 personas trabajaran durante un día y que ahora completaría una persona en unas horas.
La compatibilidad del software es importante porque un procesador necesita más que hardware capaz de realizar operaciones aritméticas. Los modelos, las bibliotecas matemáticas y las herramientas de implementación deben funcionar en conjunto. Las demostraciones de software abordan cuánto trabajo de ingeniería podrían necesitar los clientes antes de convertir una nueva GPU en un servicio operativo.
La TY1200 amplía la propuesta a los robots
El evento de Shanghái también presentó la Tongyang TY1200, un procesador distinto dirigido a PC con IA e inteligencia artificial incorporada, incluidos robots que perciben y actúan en el mundo físico. Su capacidad de cálculo denso declarada es de 300 TOPS, o 300 billones de operaciones por segundo. El cálculo denso cuenta el trabajo sin depender de operaciones omitidas que involucran valores cero.
Iluvatar CoreX afirmó que la TY1200 alcanzó 1,2 veces el rendimiento de la Thor T5000 de Nvidia en pruebas con Qwen3.8-27B y Qwen3.6-35B-A3B. Para los modelos Cosmos-R2-2B y Cosmos-R2-8B en escenarios de IA física, informó de un rendimiento equivalente al 158% y al 180% del nivel de referencia de la Thor T5000, respectivamente.
La empresa también afirmó que la TY1200 podía ejecutar simulaciones físicas aceleradas por GPU mediante MuJoCo-Warp. Esto permite que un sistema de desarrollo de robots simule movimientos, entrene una política de control y compruebe acciones localmente. Una política de control es el conjunto de instrucciones aprendidas que un robot utiliza para decidir cómo moverse.
Entre las aplicaciones declaradas figuran robots que asisten a personas durante consultas médicas, visión industrial y orientación de visitantes. La sucesora prevista, la TY2000, tiene un objetivo de cálculo declarado de 600T. En conjunto, estos productos amplían la estrategia de la empresa, desde grandes servidores de IA hasta equipos que operan cerca de los usuarios y las máquinas.
Puntos clave
- Iluvatar CoreX presentó el hardware Tiangai 300 en Shanghái el 28 de octubre de 2026.
- La empresa citó pruebas de Shanghai Electric Group que indicaron un rendimiento por tarjeta equivalente a 1,05 veces el de la H200 de Nvidia.
- Según lo informado, una demostración de entrenamiento de Qwen3-32B con ocho GPU alcanzó un rendimiento por tarjeta de 1,33 veces el de la H100, con precisión FP8.
- No se ha publicado el método detallado de la prueba de referencia de terceros que sustenta la afirmación principal.
- El rack IXL144 contiene 144 GPU y 18 CPU, y la empresa afirma que reduce un 40% el costo por millón de tokens efectivos.
- Según lo informado, una implementación aparte que repartía el trabajo entre GPU y XPU redujo un 60% la latencia de decodificación.
- El evento también abordó la automatización del software y las aplicaciones de la TY1200 en IA local y simulación robótica.