Un modelo que aprende las letras del ARN y sus conexiones
Investigadores de la Universidad de Ciencia y Tecnología de China han publicado structRFM, un modelo fundacional abierto de ARN entrenado con 21 millones de pares de secuencias de ARN y estructuras anotadas mediante métodos computacionales. La publicación incluye los datos de entrenamiento emparejados, los pesos del modelo y el código fuente, lo que proporciona a otros laboratorios los materiales necesarios para reproducir el trabajo y adaptar el sistema.
Contenido
- Un modelo que aprende las letras del ARN y sus conexiones
- Por qué el plegamiento importa tanto como la secuencia
- Cómo se reunieron 21 millones de pares de entrenamiento
- Cómo se entrenó el modelo con información oculta
- Qué revelaron las pruebas estructurales
- Del procesamiento del ARN a la clasificación funcional
- Qué ofrece a los investigadores la publicación abierta
- El equipo y el calendario de publicación
- Qué cambian los resultados para la investigación del ARN
- Puntos clave
El estudio, publicado por Nature el 4 de noviembre de 2026, describe un modelo que aprende tanto el orden de los componentes moleculares del ARN como las conexiones que ayudan a esas moléculas a plegarse. Su adaptación para predecir estructuras tridimensionales, llamada Zfold, obtuvo un rendimiento que los autores describen como comparable al de AlphaFold3 en las evaluaciones CASP15-natural, CASP16 y RNA-Puzzles.
La ventaja práctica es que, una vez entrenado, structRFM solo necesita una secuencia de ARN como entrada. Produce información que los investigadores pueden utilizar para varias tareas, como predecir estructuras moleculares, identificar sitios implicados en el procesamiento del ARN y clasificar moléculas de ARN según su función.
El artículo de investigación sobre structRFM publicado en Nature presenta el trabajo como una forma de aprovechar el conocimiento estructural en distintas tareas de predicción. Peng Xiong y S. Kevin Zhou son los autores de correspondencia, y Heqin Zhu es el primer autor.
Por qué el plegamiento importa tanto como la secuencia
El ARN participa en la producción de proteínas, la regulación génica y el procesamiento de los mensajes genéticos. Su secuencia es el orden de sus nucleótidos, las unidades moleculares que suelen representarse con las letras A, U, C y G. Ese orden contiene información, mientras que la forma en que se pliega la molécula contribuye a determinar cómo funciona.
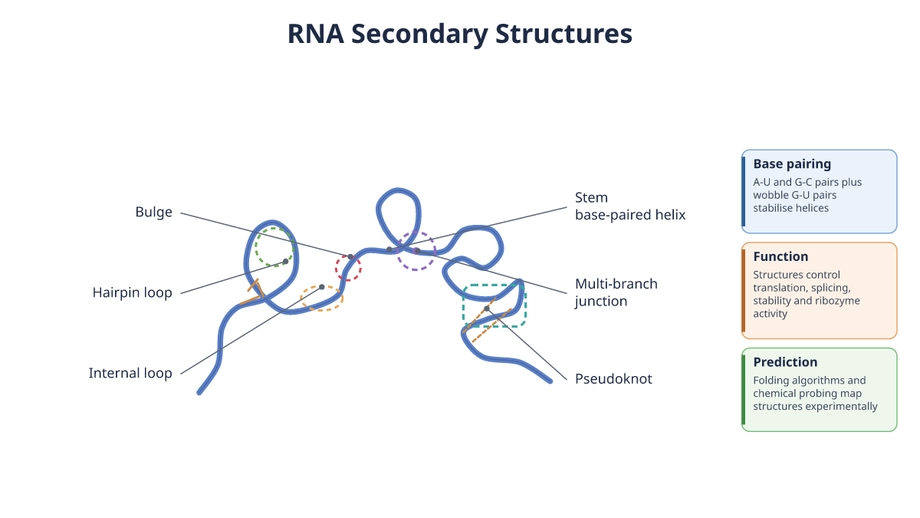
Algunas partes de una cadena de ARN pueden emparejarse con otras partes de la misma cadena. Esas conexiones crean una estructura secundaria, un patrón de regiones emparejadas, tallos y bucles. Después, la molécula se pliega hasta adquirir una forma tridimensional, conocida como estructura terciaria, que influye en su actividad y en sus interacciones con otras moléculas.
Muchos modelos de lenguaje de ARN aprenden patrones a partir de grandes colecciones de secuencias, de manera parecida a como un modelo de lenguaje aprende relaciones entre palabras. Durante el entrenamiento, structRFM incorpora información sobre qué nucleótidos se emparejan, lo que le ayuda a aprender las conexiones entre posiciones que pueden estar muy alejadas en la secuencia.
Los investigadores buscaron conservar la flexibilidad de un modelo fundacional: un sistema entrenado de forma amplia cuyas características aprendidas pueden adaptarse a distintos fines. Su objetivo era incorporar la información sobre el plegamiento a esa base compartida, en lugar de entrenar un sistema útil para una sola tarea estructural.
Cómo se reunieron 21 millones de pares de entrenamiento
El equipo creó un conjunto de datos con unos 21 millones de pares de secuencias de ARN y estructuras secundarias. Las anotaciones estructurales se generaron mediante métodos computacionales, lo que permitió entrenar el modelo a una escala mucho mayor que la de una colección formada únicamente por estructuras determinadas mediante experimentos de laboratorio.
Las predicciones informáticas pueden contener errores y reflejar los puntos fuertes y débiles del método que las generó. Para reducir la dependencia de un único predictor, los investigadores introdujeron MUSES, un conjunto de predicciones de estructura secundaria que integra varias fuentes. Un conjunto de este tipo combina información de distintas fuentes de predicción, en lugar de depender por completo de una sola.
MUSES aborda un problema central de la enseñanza de modelos con estructuras predichas: los errores repetidos en las anotaciones de entrenamiento pueden influir en lo que aprende el modelo. La combinación de predicciones estructurales se diseñó para reducir el sesgo del predictor y conservar, al mismo tiempo, información útil sobre el emparejamiento de bases.
Los recursos de entrenamiento y evaluación del estudio se basan en colecciones biológicas consolidadas, entre ellas RNAcentral, Rfam y Protein Data Bank. La declaración sobre los datos identifica las versiones pertinentes, incluidas RNAcentral 24.0 y Rfam 14.10 y 15.0, para que los investigadores puedan rastrear los conjuntos de datos utilizados en los experimentos.
Cómo se entrenó el modelo con información oculta
structRFM utiliza el modelado de lenguaje enmascarado, un método de entrenamiento en el que se ocultan partes de una entrada y el modelo aprende a recuperar la información que falta a partir del contexto circundante. En el caso del ARN, esto significa aprender relaciones entre nucleótidos, no entre palabras.
El equipo incorporó el emparejamiento de bases a este proceso mediante una operación de correspondencia de pares. Una proporción de enmascaramiento dinámica equilibra el entrenamiento guiado por conexiones estructurales con el enmascaramiento de posiciones individuales de nucleótidos. Esto ofrece al modelo oportunidades para aprender tanto patrones locales de secuencia como relaciones vinculadas al plegamiento.
El modelo resultante proporciona tres tipos de características: información sobre la secuencia en su conjunto, información sobre cada nucleótido e información sobre pares de nucleótidos. Una característica es una representación numérica que otro sistema de predicción puede utilizar. Las distintas tareas pueden recurrir a diferentes niveles de esa representación.
Los investigadores también realizaron experimentos de ablación, que eliminan o modifican partes de un modelo para comprobar su contribución. Estos experimentos respaldaron la contribución tanto de la información estructural como de la estrategia de enmascaramiento a las mejoras descritas, y aportaron pruebas a favor de las decisiones de diseño de structRFM.
Qué revelaron las pruebas estructurales
structRFM obtuvo un buen rendimiento en la clasificación de homología sin entrenamiento específico. La homología se refiere a las relaciones heredadas de un origen evolutivo común. En este contexto, la clasificación sin entrenamiento específico evalúa la utilidad de las representaciones aprendidas para reconocer esas relaciones sin entrenar el modelo específicamente para la tarea de clasificación en cuestión.
Los autores también informan de mejoras en la predicción de estructuras secundarias y de un buen rendimiento con familias de ARN publicadas recientemente. Una familia de ARN agrupa moléculas relacionadas que comparten características de secuencia o estructura. Las pruebas con familias recién publicadas permiten evaluar cómo funciona el modelo más allá de los grupos conocidos incluidos en conjuntos de datos consolidados.
Para predecir estructuras terciarias, el equipo desarrolló Zfold, que adapta las características aprendidas por structRFM a un modelo capaz de predecir formas tridimensionales. Los autores informan de mejoras tanto en las formas predichas como en las estructuras secundarias extraídas de esas predicciones.
Zfold se evaluó con CASP15-natural, CASP16 y RNA-Puzzles, conjuntos de referencia utilizados para evaluar la predicción de estructuras moleculares. En esas evaluaciones, el artículo describe su rendimiento como comparable al de AlphaFold3. La comparación se refiere a los resultados de Zfold en esos conjuntos de referencia concretos, mientras que structRFM proporciona las representaciones subyacentes del ARN.
El estudio presenta varios tipos de resultados satisfactorios, en lugar de una sola puntuación de precisión que abarque todos los usos. Reconocer secuencias relacionadas, predecir pares de bases y reconstruir una forma tridimensional son problemas distintos, cada uno de los cuales requiere su propia evaluación.
Del procesamiento del ARN a la clasificación funcional
structRFM también se probó en tareas relacionadas con la función del ARN. Entre ellas se incluyeron la predicción de sitios de empalme, la identificación de sitios internos de entrada al ribosoma y la clasificación de ARN no codificantes, lo que amplió la evaluación más allá de la forma molecular.
Los sitios de empalme marcan los límites que se utilizan cuando las células procesan los mensajes de ARN. Durante el empalme, se eliminan algunas partes y se unen las secciones restantes. Predecir esos límites ayuda a los investigadores a estudiar cómo se ensambla un mensaje genético antes de utilizarse para producir una proteína.
Los sitios internos de entrada al ribosoma, o elementos IRES, son regiones de ARN que permiten que la maquinaria celular encargada de producir proteínas inicie la traducción internamente. Identificarlos requiere reconocer patrones funcionales dentro de una secuencia, por lo que esta tarea constituye otra prueba de la información capturada durante el preentrenamiento.
Los ARN no codificantes desempeñan funciones distintas de servir como moldes para la producción de proteínas. Clasificarlos implica asignar las moléculas a grupos pertinentes. Los autores informan de un mejor rendimiento en estas tareas funcionales, lo que muestra que las representaciones aprendidas siguieron siendo útiles cuando el objetivo de predicción pasó de la estructura a la función biológica.
El equipo también amplió el modelo para clasificar ARN largos no codificantes mediante una estrategia de segmentación. Dividir una secuencia larga en secciones permite aplicar el modelo a entradas que, de otro modo, serían difíciles de procesar como una sola unidad.
Qué ofrece a los investigadores la publicación abierta
La publicación abarca tres recursos con distintos usos. El conjunto de datos proporciona los ejemplos utilizados para el aprendizaje. Los pesos del modelo contienen los valores numéricos aprendidos durante el entrenamiento. El código fuente describe cómo se implementa y ejecuta el programa.
El acceso a los pesos permite a los investigadores trabajar con un modelo ya entrenado, en lugar de repetir todo el proceso de preentrenamiento. El acceso a los datos y al código facilita un examen más detallado del procedimiento de entrenamiento, la reproducción de los experimentos y el desarrollo de enfoques alternativos.
El artículo identifica el repositorio del proyecto en GitHub como heqin-zhu/structRFM. También incluye un archivo de Zenodo para el conjunto de datos de preentrenamiento, con el DOI 10.5281/zenodo.18272040, y otro archivo para el código fuente y los puntos de control del modelo, con el DOI 10.5281/zenodo.18274292. Un DOI es un identificador persistente diseñado para que un recurso de investigación pueda localizarse a lo largo del tiempo.
La declaración sobre los datos indica que los conjuntos de datos de entrenamiento y prueba están disponibles públicamente en el repositorio del proyecto. También proporciona la partición de IRES procesada que se utilizó en el estudio y los datos de origen de las figuras. Los autores afirman que no hay restricciones para acceder a los datos.
Estos detalles son importantes para hacer comparaciones. Los investigadores pueden examinar qué conjuntos de datos y particiones se utilizaron, repetir las evaluaciones y comprobar si una decisión de entrenamiento diferente cambia los resultados. Por lo tanto, la publicación permite tanto examinar los hallazgos como reutilizar el modelo.
El equipo y el calendario de publicación
El trabajo se llevó a cabo en la Escuela de Ingeniería Biomédica de la USTC y en el laboratorio de Imágenes Médicas, Robótica, Computación Analítica y Aprendizaje, conocido como MIRACLE. Los autores indican afiliaciones en Hefei y en el Instituto de Investigación Avanzada de Suzhou de la USTC. El coautor Ruifeng Li pertenece a la Facultad de Ciencias y Tecnología de la Computación de la Universidad de Zhejiang, en Hangzhou.
Zhou, profesor, y Xiong, investigador especial, concibieron y supervisaron el estudio. Zhu diseñó e implementó el marco, llevó a cabo el preentrenamiento y varios experimentos de predicción estructural y clasificación de ARN, y analizó los resultados. Otros integrantes del equipo trabajaron en las pruebas de homología, las comparaciones de conjuntos de datos, la identificación de IRES y la evaluación estructural.
La publicación y la difusión pública del trabajo se produjeron en dos fechas del calendario:
- 4 de noviembre de 2026: Nature indica que ese día se publicó An open structure-guided RNA foundation model for generalizable prediction.
- 5 de noviembre de 2026: El trabajo y su publicación abierta se difundieron en China; se informó de que la publicación en línea había aparecido a primera hora de la mañana.
Los autores informan de que recibieron apoyo de la Fundación Nacional de Ciencias Naturales de China, el Programa Nacional Clave de Investigación y Desarrollo, programas de investigación de Jiangsu y Suzhou y el Proyecto Sanming de Medicina de Shenzhen. Declaran que no tienen conflictos de intereses.
Qué cambian los resultados para la investigación del ARN
structRFM ofrece una base común para varias actividades de investigación. Un laboratorio que estudie el procesamiento del ARN puede adaptar el mismo modelo subyacente que otro grupo utiliza para investigar el plegamiento o clasificar moléculas no codificantes. Cada aplicación sigue requiriendo un desarrollo y una evaluación específicos para la tarea.
La combinación de 21 millones de pares de entrenamiento, el aprendizaje guiado por la estructura y los puntos de control publicados proporciona a los investigadores un sistema concreto que pueden examinar, en lugar de solo una descripción de un algoritmo. MUSES y los experimentos de enmascaramiento también ofrecen decisiones de diseño específicas que otros equipos pueden poner a prueba o modificar.
Los hallazgos descritos se centran en la predicción computacional y la clasificación. El desarrollo de aplicaciones biomédicas exigiría más experimentos biológicos, entre ellos comprobar las estructuras predichas y evaluar las funciones asignadas a moléculas de ARN concretas.
El artículo no establece un calendario para una aplicación clínica. El cambio inmediato es el acceso: investigadores de todo el mundo pueden obtener los recursos de entrenamiento, examinar la implementación e investigar si las mejoras descritas también se observan en sus propios conjuntos de datos de ARN.
Puntos clave
- Investigadores de la USTC publicaron structRFM, un modelo fundacional de ARN entrenado con unos 21 millones de pares de secuencias y estructuras secundarias.
- El modelo aprende patrones de secuencia y relaciones de emparejamiento de bases y, después, genera características a partir únicamente de la secuencia como entrada.
- MUSES combina fuentes de predicción estructural, mientras que el enmascaramiento dinámico equilibra la información estructural y la de los nucleótidos durante el entrenamiento.
- Los autores informan de un buen rendimiento en la clasificación de homología y de mejoras en la predicción de estructuras secundarias, incluidas pruebas con familias de ARN publicadas recientemente.
- Zfold, la adaptación del modelo para predecir estructuras terciarias, obtuvo un rendimiento que se describe como comparable al de AlphaFold3 en tres conjuntos de referencia concretos.
- El conjunto de datos, los pesos del modelo, el código fuente y los recursos de evaluación están disponibles públicamente para su reutilización y para reproducir los resultados.