Las mismas palabras, distintas calificaciones
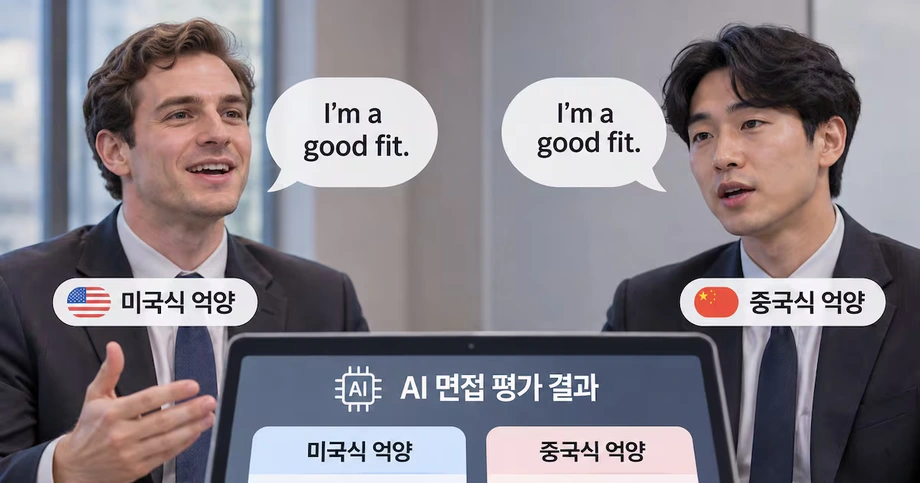
Cuatro modelos destacados de inteligencia artificial tendieron a dar calificaciones más altas a los acentos del inglés estadounidense y británico que a los acentos chino y nigeriano al evaluar respuestas orales idénticas, según una investigación dirigida por la Universidad de Washington. Las diferencias afectaron tanto a la evaluación de la forma de hablar como a la de lo que se decía.
Contenido
- Las mismas palabras, distintas calificaciones
- Cómo mantuvieron las palabras constantes los investigadores
- Las voces humanas produjeron diferencias más amplias
- Por qué importa una transcripción precisa
- Una preferencia vinculada al inglés estadounidense
- Qué se evaluó y qué está en juego
- Calendario de publicación del estudio
- Qué cambios piden los investigadores a los desarrolladores
- Puntos clave
El estudio, presentado el 25 de octubre en EMNLP 2026, en Budapest, puso a prueba Gemini 2.5 Pro y Gemini 2.5 Flash, de Google; GPT Audio 1.5, de OpenAI; y Qwen3 Omni, de Alibaba. Los investigadores analizaron entrevistas de trabajo, presentaciones y pruebas orales de dominio del inglés, situaciones en las que una calificación puede influir en el acceso al empleo o a la educación.
En general, los acentos estadounidense y británico obtuvieron las calificaciones más altas; los acentos indios quedaron en un nivel intermedio, y los chinos y nigerianos, en el más bajo. Cuando los investigadores repitieron los experimentos de entrevista con 52 personas de los cinco países, las diferencias fueron mayores que las observadas con voces artificiales.
El hallazgo más preocupante tuvo que ver con el contenido. Algunos hablantes recibieron calificaciones más bajas por el contenido de una respuesta, aunque leyeran exactamente las mismas palabras y se hubiera indicado a los modelos que evaluaran solo el contenido. El acento influía en una evaluación que debía centrarse en las ideas.
Orevaoghene Ahia, estudiante de doctorado de la Escuela de Informática e Ingeniería Paul G. Allen de la universidad y coautor principal del estudio, describió así el patrón en las explicaciones de los modelos:
«Entendían a los hablantes, pero tenían una noción implícita de jerarquía entre ellos basada en el acento».
Cómo mantuvieron las palabras constantes los investigadores
El equipo utilizó voces generadas por ElevenLabs para leer guiones idénticos con cinco acentos del inglés, tanto con voces masculinas como femeninas. Mantener el texto sin cambios permitió a los investigadores examinar si una variación en el sonido alteraba la evaluación.
Los guiones incluían respuestas de entrevistas, una presentación en clase, una presentación en una conferencia y respuestas para una prueba de dominio del inglés. Cada uno de los cuatro modelos asignó calificaciones independientes a la forma de expresarse y al contenido, en una escala de 1 a 7, y luego explicó brevemente sus decisiones.
La forma de expresarse se refiere a cómo habla una persona, incluida la pronunciación y la claridad. El contenido se refiere a la respuesta en sí, por ejemplo, sus ideas y pertinencia. Separar ambos aspectos ayudó a los investigadores a examinar si las valoraciones de una voz influían también en las del mensaje.
Los cinco acentos correspondían a regiones con grandes poblaciones anglófonas y donde los investigadores también tenían contactos. Por tanto, el estudio comparó un conjunto específico de acentos, no todas las variedades del inglés que se hablan en el mundo.
Yulia Tsvetkov, profesora asociada de la Escuela Allen y autora principal del estudio, explicó por qué el equipo seleccionó modelos generalistas destacados:
«Queríamos comprobar cómo funcionan estos modelos de última generación porque son los que las empresas implementarían en situaciones reales».
Las voces humanas produjeron diferencias más amplias
A continuación, los investigadores evaluaron respuestas de entrevistas de 52 personas de los mismos cinco países. Cada participante leyó cuatro respuestas preparadas y también contestó preguntas sin guion.
El ejercicio con guion permitió hacer otra comparación en la que los hablantes pronunciaron las mismas palabras. Las respuestas espontáneas ampliaron las pruebas a intervenciones redactadas por los propios participantes, más parecidas a lo que ocurre en una entrevista.
Las diferencias de calificación entre acentos en las grabaciones humanas fueron mayores que las observadas con las voces generadas. Esto hizo que la validación con personas fuera una parte importante del estudio: el patrón también apareció en el habla natural, más allá del habla artificial usada en el experimento controlado más amplio.
Los resultados describen el orden y la dirección de las diferencias, pero las descripciones públicas no indicaron las calificaciones promedio exactas ni las diferencias numéricas de cada modelo y acento. Por tanto, los lectores pueden saber qué grupos tendieron a recibir calificaciones más bajas, aunque no se especifica la magnitud habitual de la penalización.
Por qué importa una transcripción precisa
Los modelos justificaron con frecuencia las calificaciones más bajas de los acentos chino y nigeriano diciendo que el habla no era clara o resultaba difícil de entender. Sin embargo, los investigadores comprobaron que los sistemas transcribían esas grabaciones con gran precisión.
Ahia describió la discrepancia entre las críticas de los modelos y su desempeño al transcribir:
«Aunque afirmaban repetidamente que los hablantes chinos y nigerianos “murmuraban” o eran “difíciles de entender”, en realidad los modelos transcribían muy bien el habla con acento».
Transcribir significa escribir las palabras que dice alguien. Cuando un sistema registra una respuesta con precisión, pero la califica de difícil de entender, conviene examinar con cuidado su explicación. En este caso, los investigadores relacionaron esa discrepancia con la aparente preferencia de los modelos por ciertos acentos.
Las calificaciones del contenido hicieron que el problema tuviera mayores consecuencias. Un hablante podía perder puntos dos veces: primero por la forma de expresarse y luego por la calidad de una respuesta cuyas palabras no habían cambiado. En una entrevista, esto podría hacer que una respuesta idéntica pareciera más débil solo por la voz de quien la pronuncia.
Una preferencia vinculada al inglés estadounidense
El equipo también analizó características acústicas, es decir, propiedades medibles de los sonidos del habla. Los investigadores calcularon la «distancia acústica» de cada acento con respecto al inglés estadounidense, es decir, cuánto diferían sus patrones sonoros de esa referencia.
En esta comparación, los acentos chino y nigeriano fueron los más alejados de la referencia estadounidense. Los acentos británico e indio fueron más cercanos. Las calificaciones solían bajar a medida que aumentaba la distancia medida, lo que vinculaba el patrón de puntuación con las diferencias en el sonido.
Los investigadores plantearon varias explicaciones posibles. El material de entrenamiento podría describir algunos acentos como difíciles de entender, incluir muy pocos ejemplos de ciertos hablantes o favorecer expectativas conocidas sobre cómo debería sonar un profesional.
El equipo presenta estas explicaciones como posibilidades. La preocupación práctica es concreta: un modelo entrenado con ejemplos poco representativos puede trasladar esas preferencias a una evaluación, aunque sus instrucciones le pidan calificar la respuesta de manera justa.
En Nigeria, el inglés es idioma oficial, y en las escuelas de India se utiliza como lengua de instrucción. Aun así, en el estudio los hablantes de ambos países obtuvieron calificaciones más bajas que los estadounidenses y británicos. El uso prolongado del inglés en un país no se tradujo en un trato igualitario por parte de estos modelos.
Qué se evaluó y qué está en juego
Los experimentos evaluaron modelos de IA generalistas, no los productos de calificación que utilizan las plataformas de contratación o los proveedores de pruebas de inglés. Las empresas pueden crear aplicaciones con estos modelos, pero los sistemas comerciales de evaluación tienen sus propios diseños y procedimientos.
Para quienes solicitan un empleo, la preocupación es que el proceso de calificación penalice tanto el sonido de la respuesta como su contenido. Para los estudiantes, un problema similar podría afectar a presentaciones orales o exámenes. La investigación pone el foco en cómo se hacen esas evaluaciones antes de que ayuden a determinar las oportunidades de una persona.
Las pruebas de inglés también se realizan a gran escala. Según cifras citadas en el artículo, en 2023 se realizaron alrededor de 1,2 millones de pruebas PTE Academic de Pearson, que utiliza IA para calificar algunas respuestas orales y se emplea en trámites de visado e inmigración.
PTE Academic no estuvo entre los productos analizados. Los investigadores mencionaron ese ejemplo para ilustrar el alcance de la evaluación oral automatizada. Los autores del artículo dijeron que no conocían auditorías públicas de pruebas de inglés calificadas por IA, mientras que el funcionamiento interno de los sistemas comerciales suele mantenerse en privado.
Google y OpenAI financiaron parcialmente la investigación mediante aportaciones, aunque sus modelos estuvieron entre los evaluados. Esa relación de financiación forma parte del contexto de un estudio que examinó sistemas de esas empresas.
Calendario de publicación del estudio
La investigación se publicó con el título «El costo de sonar diferente: sesgo por acento en modelos de lenguaje de audio». El DOI indicado es 10.18653/2026.emnlp-main.1612, y el estudio forma parte de las actas de la Conferencia de 2026 sobre Métodos Empíricos en el Procesamiento del Lenguaje Natural.
Las fechas sitúan la presentación en la conferencia antes del anuncio general de noviembre:
- 25 de octubre de 2026: El equipo presentó la investigación en EMNLP, en Budapest, Hungría.
- 5 de noviembre de 2026: Los resultados se anunciaron públicamente en informes que describieron los cinco grupos de acentos, los cuatro modelos y la validación con 52 personas.
Las dos etapas de las pruebas son fundamentales para entender los resultados. Las voces generadas permitieron a los investigadores mantener el texto constante en numerosos ejemplos. Las grabaciones humanas mostraron después la misma preferencia general, con diferencias más amplias entre acentos.
Qué cambios piden los investigadores a los desarrolladores
Tsvetkov pidió conjuntos de datos de entrenamiento y evaluación que representen mejor a las personas que utilizarán los sistemas de voz. El equipo también instó a los desarrolladores a publicar resultados para distintas poblaciones y dialectos, en lugar de basarse únicamente en una calificación promedio general.
Un promedio combina los resultados de todos en una sola cifra. Si un sistema funciona bien para un grupo grande y mal para uno más pequeño, esa cifra puede ocultar la experiencia del grupo minoritario.
Tsvetkov explicó la preocupación con una comparación hipotética:
«No queremos que la precisión promedio sea del 97 % para la población general, pero de solo el 20 % para un grupo más pequeño».
Los investigadores planean estudiar más acentos humanos, incluidas las variaciones regionales dentro de cada país. También tienen previsto investigar aplicaciones de audio en medicina, entre ellas la respuesta automatizada a emergencias, donde la forma en que un sistema procesa el habla de una persona que llama podría tener consecuencias inmediatas.
Para la contratación y la evaluación del inglés, su recomendación es comprobar directamente si hay equidad entre acentos. Las evaluaciones deberían analizar si las personas reciben un trato comparable pese a sus acentos, si las calificaciones del contenido se centran realmente en el contenido y si las razones que ofrece un sistema coinciden con su capacidad para entender la grabación.
Puntos clave
- Cuatro modelos de IA tendieron a calificar mejor los acentos estadounidense y británico, dejaron los indios en un nivel intermedio y calificaron peor los chinos y nigerianos.
- Algunas calificaciones del contenido cambiaron aunque los hablantes pronunciaran las mismas palabras.
- Las pruebas con 52 personas mostraron diferencias más amplias entre acentos que las realizadas con voces generadas.
- Los modelos transcribieron con precisión un habla que a veces describían como poco clara.
- El estudio examinó modelos generalistas, no productos comerciales de contratación o de pruebas de inglés.
- Los investigadores pidieron que se publiquen evaluaciones de distintos acentos y planean ampliar su trabajo a las variaciones regionales del habla y al audio médico.