Una actualización para programar llega junto con un servicio público de búsqueda
DeepSeek lanzó V4.1-Flash-1017 el 17 de octubre de 2026 y actualizó al mismo tiempo su sitio web, su aplicación y su API. También abrió dos servicios que permiten a los desarrolladores buscar en la web y recuperar páginas específicas. La empresa fija el precio de cada servicio, Search y Fetch, en 0,75 dólares por cada 1.000 llamadas. La facturación de las llamadas que cumplan los requisitos y se realicen mediante herramientas de servidor comenzará a las 16:00 UTC del 31 de octubre, o a la medianoche del 1 de noviembre en Pekín.
Contenido
- Una actualización para programar llega junto con un servicio público de búsqueda
- Qué significa en la práctica programar a partir de un deseo
- En qué evaluaciones destacan más las mejoras
- Por qué las respuestas más breves pueden reducir el costo de las tareas
- Search encuentra páginas; Fetch las recupera
- Cuánto pagarán los desarrolladores y desde cuándo
- Las actualizaciones de Harness conectan el modelo con el trabajo cotidiano
- Pesos abiertos y opciones de implementación
- Las fechas que marcan el despliegue
- Puntos clave
El lanzamiento se produce 37 días después de la primera aparición de V4.1 Flash, el 10 de septiembre. Los desarrolladores pueden seguir usando el nombre de modelo deepseek-flash; el método existente para llamar a la API del modelo y sus precios no cambian. DeepSeek también publica el modelo actualizado en Hugging Face y ModelScope.
El anuncio oficial del lanzamiento de DeepSeek pone el desarrollo de proyectos completos en el centro de la actualización. Entre sus ejemplos figuran un modelo de la Ciudad Prohibida de Pekín, un juego de carreras para navegador, una recreación de Portal 2 con el motor Godot y una escena 3D animada que recorre la historia desde la prehistoria hasta la era moderna.
DeepSeek afirma que el modelo ofrece mejores resultados en menos tiempo y genera respuestas más breves. Para los desarrolladores, estos cambios reducen dos costos a la vez: el tiempo durante el cual una tarea automatizada ocupa una computadora y la cantidad de texto generado que factura el servicio del modelo.
El lanzamiento de Search añade otro elemento a ese flujo de trabajo. Una aplicación de IA ahora puede usar el modelo de DeepSeek para planificar una tarea, su motor de búsqueda para encontrar información actual y su servicio Fetch para incorporar a la tarea una página web seleccionada.
Qué significa en la práctica programar a partir de un deseo
DeepSeek describe la principal aspiración del proyecto como programar a partir del deseo de un usuario: una persona explica en lenguaje cotidiano lo que quiere y la IA se encarga de una mayor parte del trabajo necesario para convertir esa solicitud en un proyecto funcional.
Las cuatro demostraciones abarcan distintos tipos de trabajo. El ejemplo de la Ciudad Prohibida se centra en el modelado 3D. El juego de carreras requiere interacción con el navegador. La recreación de Portal 2 utiliza un motor de juego existente, Godot. Valley of Ages presenta entornos cambiantes a lo largo de un extenso período de la historia humana.
DeepSeek afirma que estos proyectos se crearon dentro de DeepSeek Harness con relativamente pocas instrucciones, material de referencia limitado y pocas rondas de interacción. La empresa atribuye la mejora al aprendizaje por refuerzo con autoevaluación, un método de entrenamiento en el que la retroalimentación sobre el trabajo realizado ayuda a orientar el comportamiento posterior.
Un harness es el software que rodea a un modelo de lenguaje y gestiona herramientas, archivos, sesiones y ejecución de tareas. El modelo puede proponer código o decidir qué hacer a continuación; el harness proporciona el entorno en el que se llevan a cabo esas acciones. Así, el software que lo rodea también forma parte del proceso de desarrollo del proyecto, junto con el propio modelo.
En qué evaluaciones destacan más las mejoras
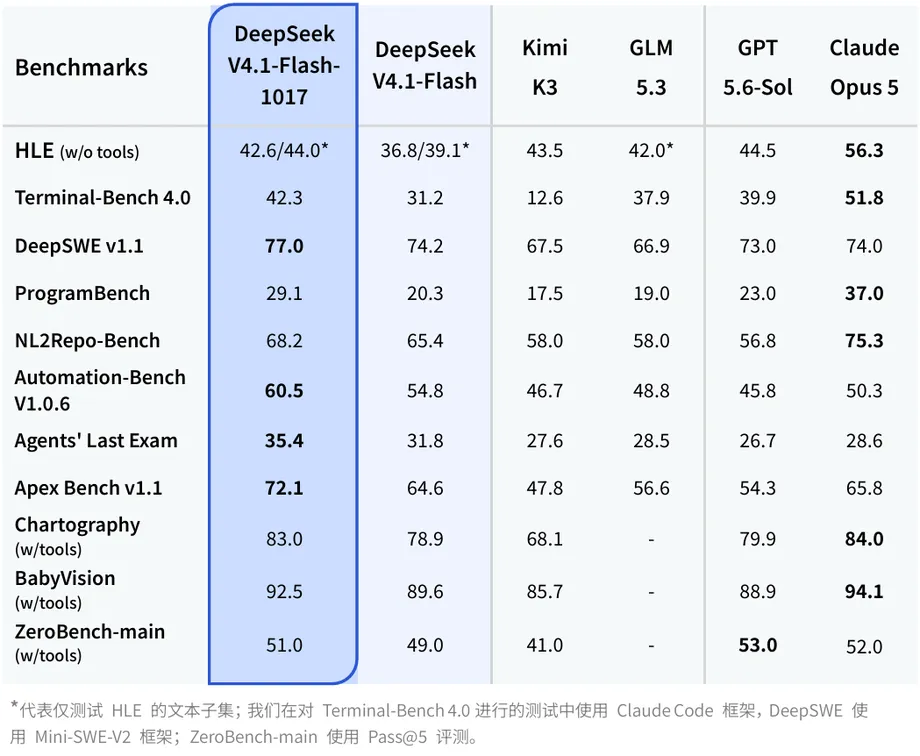
En las evaluaciones publicadas por DeepSeek, el modelo actualizado obtiene 77,0 en DeepSWE v1.1, frente a 74,2 en la versión de septiembre. Es una mejora de 2,8 puntos en una evaluación de tareas de ingeniería de software. En la comparación de la empresa, Claude Opus 5 obtuvo 74,0 y GPT 5.6-Sol, 73,0.
Terminal-Bench 4.0 muestra una mejora mayor con respecto a la versión Flash anterior: sube de 31,2 a 42,3, un aumento de 11,1 puntos. ProgramBench pasa de 20,3 a 29,1, mientras que NL2Repo-Bench sube de 65,4 a 68,2.
DeepSeek también informa de mejoras en tareas con agentes, sistemas que utilizan herramientas para llevar a cabo una secuencia de acciones. Automation-Bench v1.0.6 sube de 54,8 a 60,5; Agents' Last Exam, de 31,8 a 35,4; y Apex Bench v1.1, de 64,6 a 72,1.
En la tabla comparativa de DeepSeek, el modelo actualizado lidera en DeepSWE, Automation-Bench, Agents' Last Exam y Apex Bench, por delante de los modelos citados de Anthropic, OpenAI, Kimi y Zhipu. Claude Opus 5 obtiene puntuaciones más altas en varias otras evaluaciones, entre ellas Terminal-Bench, ProgramBench y NL2Repo.
Las condiciones de las pruebas influyen en estas cifras. DeepSeek sitúa Terminal-Bench 4.0 en 42,3, mientras que una evaluación de Artificial Analysis le asigna 26,8. No se detallan las configuraciones necesarias para explicar esa diferencia. DeepSeek identifica Claude Code como su entorno para Terminal-Bench y Mini-SWE-V2 para DeepSWE, lo que muestra que el modelo y las herramientas que lo rodean se evalúan en conjunto.
Por qué las respuestas más breves pueden reducir el costo de las tareas
DeepSeek califica la actualización como una mejora de Pareto en rendimiento y costo. En términos sencillos, afirma que los usuarios obtienen mejores resultados y gastan menos, en lugar de pagar más por una mayor calidad.
Los servicios de modelos suelen cobrar por tokens, las pequeñas unidades en las que se divide el texto para procesarlo. Una respuesta generada más breve utiliza menos tokens de salida. Un agente de programación puede producir muchas respuestas durante un solo trabajo, por lo que reducir el texto innecesario en esos pasos puede disminuir el costo total.
DeepSeek afirma que también se redujeron los tiempos de ejecución de las tareas. Esto importa en proyectos que requieren ediciones, pruebas y uso de herramientas repetidos, donde el usuario espera un resultado terminado en lugar de una sola respuesta. La empresa describe el lanzamiento técnico como una actualización pequeña, aunque afirma que mejora el razonamiento, la programación, las tareas con agentes y las evaluaciones visuales.
Search encuentra páginas; Fetch las recupera
Los servicios Search y Fetch de DeepSeek cumplen funciones distintas. Search recibe una consulta y devuelve resultados ordenados por relevancia. Fetch recibe una página web específica y recupera su título y contenido en formato Markdown, un formato de texto sencillo que conserva encabezados, listas y otras estructuras útiles.
Por ejemplo, un desarrollador podría usar Search para encontrar documentación actualizada de software y luego Fetch para recuperar la página pertinente antes de pedir al modelo que escriba código. Las aplicaciones que combinan documentos recuperados con respuestas generadas suelen llamarse sistemas de generación aumentada por recuperación, o RAG.
Los servicios utilizan la dirección base api.deepseek.com y el mismo sistema de credenciales de API que el servicio de modelos de DeepSeek. Los endpoints son POST /v1/tools/search y POST /v1/tools/fetch. Devuelven datos estructurados en JSON que el software puede leer y transferir entre herramientas.
Search acepta consultas de hasta 128 caracteres. Los desarrolladores pueden solicitar entre uno y 50 resultados; el valor predeterminado es 10. Los resultados pueden incluir títulos, direcciones, resúmenes breves, resúmenes más extensos pensados para modelos, fechas de publicación y, cuando está disponible, el contenido completo de la página.
DeepSeek afirma que su motor de búsqueda ya ofrece búsquedas en su sitio web y su API, y que procesa cientos de millones de solicitudes al día en todo el mundo. La empresa describe un índice que abarca cientos de miles de millones de páginas web y admite búsquedas en varios idiomas.
DeepSeek también afirma que filtra la manipulación de la clasificación en las búsquedas, los intentos de influir en la información seleccionada por la IA generativa y el contenido de baja calidad generado por IA. Estas medidas afectan a la información que encuentra un agente antes de redactar una respuesta o actuar ante una solicitud del usuario.
Cuánto pagarán los desarrolladores y desde cuándo
En su anuncio en inglés, DeepSeek fija por separado el precio de Search y Fetch en 0,75 dólares por cada 1.000 llamadas. En su tarifa en yuanes, cada servicio cuesta 5 yuanes por cada 1.000 llamadas. Por lo tanto, un flujo de trabajo que realiza una búsqueda y recupera una página utiliza dos servicios con facturación independiente.
Según las reglas de facturación publicadas, Search cobra cuando devuelve correctamente una lista de resultados no vacía. Fetch cobra cuando devuelve el contenido de una página con el código HTTP 200 de respuesta satisfactoria. Las solicitudes fallidas, los resultados vacíos y las que exceden el tiempo de espera son gratuitas, y pedir más resultados de búsqueda no cambia el precio de esa llamada.
Con la tarifa indicada en yuanes, 1.000 búsquedas satisfactorias seguidas de 1.000 recuperaciones satisfactorias de páginas costarían 10 yuanes en cargos de búsqueda y recuperación. El procesamiento del modelo se factura aparte. Esta separación ayuda a los desarrolladores a calcular el costo de un agente que consulta información repetidamente mientras trabaja.
DeepSeek afirma que las llamadas a Search y Fetch realizadas mediante herramientas de servidor en DeepSeek Harness, Claude Code y Codex serán temporalmente gratuitas para los usuarios de la API de DeepSeek. La facturación de esa modalidad comenzará a las 16:00 UTC del 31 de octubre de 2026, es decir, a las 00:00 del 1 de noviembre en Pekín. La exención temporal se aplica a esas llamadas a herramientas, mientras que los cargos habituales del modelo se mantienen.
Cada cuenta puede realizar hasta cinco solicitudes por segundo a Search y cinco a Fetch; los límites se contabilizan por separado. Fetch también tiene límites adicionales para cada dominio de sitio web. Las solicitudes que superen la frecuencia permitida reciben una respuesta HTTP 429, que indica a la aplicación que reduzca el ritmo.
Las actualizaciones de Harness conectan el modelo con el trabajo cotidiano
DeepSeek recomienda Harness v0.2.1-rc.1 o una versión posterior para el modelo actualizado. Las letras rc identifican una versión candidata, preparada para pruebas antes del lanzamiento final. El modelo se optimizó específicamente para DeepSeek Harness, Tencent CodeBuddy, WorkBuddy y otros frameworks.
La versión de Harness añade opciones para descubrir complementos en índices personalizados y para pedir a un agente que cree un complemento. También mejora la gestión de dependencias al activar, desactivar, actualizar o eliminar complementos. Algunos cambios en los complementos se aplican de inmediato; otros requieren reiniciar la aplicación.
Los desarrolladores ahora disponen de interfaces para consultar y cambiar el directorio de trabajo de una sesión mediante los kits de desarrollo de software de TypeScript y Python. Otras novedades incluyen herramientas experimentales para inspeccionar sesiones, compatibilidad con directorios de trabajo Git independientes y ocultamiento automático de claves y tokens que aparecen en los mensajes enviados.
El lanzamiento continúa el trabajo en el puente de Claude Code Mods, probado en una versión alfa anterior de Harness. Ese trabajo previo contaba con tres ejemplos ejecutables y otros cuatro bloqueados por la falta de interfaces o capacidades de visualización. La capa de compatibilidad sigue siendo experimental y tiene como objetivo probar cómo se integran las capacidades de las extensiones de Claude Code en los complementos de Harness.
Además, quienes usan Harness por primera vez reciben 6 yuanes en crédito promocional sin necesidad de realizar un pago inicial. El crédito vence siete días después de su asignación y solo está disponible mientras haya fondos. Su breve período de validez lo convierte en una asignación de prueba para nuevos usuarios.
Pesos abiertos y opciones de implementación
El anuncio oficial de DeepSeek confirma que V4.1-Flash-1017 está disponible en Hugging Face y ModelScope. El lanzamiento mantiene la licencia MIT de la línea V4.1 Flash, que permite una amplia reutilización conforme a sus términos. Así, los desarrolladores pueden elegir entre usar un servicio alojado o ejecutar el modelo por su cuenta.
V4.1 Flash acepta texto e imágenes y genera texto. Su arquitectura utiliza una mezcla de expertos, lo que significa que en cada paso del procesamiento se activan partes seleccionadas del modelo, en lugar de que todo el modelo intervenga con cada token. Las descripciones de la arquitectura indican que la base tiene 552.000 millones de parámetros, de los cuales 8.000 millones se activan durante el procesamiento de la entrada y 16.000 millones durante la generación de la salida.
Una ventana de contexto de alrededor de un millón de tokens permite al modelo trabajar con grandes cantidades de material en una sola sesión. Para un agente de programación, eso puede incluir instrucciones, archivos de código fuente, conversaciones anteriores y resultados de herramientas. La ventana de contexto determina cuánto puede considerar, mientras que el límite de salida establece cuánto puede generar en una respuesta.
Las especificaciones de implementación alojada pueden variar. Una ficha de una API de terceros indica una ventana de contexto de 1.048.576 tokens y un máximo de 131.072 tokens por respuesta, además de llamadas a funciones y salidas estructuradas definidas mediante un esquema JSON. Las llamadas a funciones permiten al modelo solicitar una herramienta externa; las salidas estructuradas ofrecen a una aplicación un formato previsible para procesar.
La misma ficha permite dirigir las solicitudes a través de inference.net, DeepInfra y DeepSeek, y enviarlas a otro proveedor si uno de ellos encuentra un error. Para los desarrolladores, las opciones abarcan ahora el acceso al modelo, la selección del proveedor y los servicios de búsqueda por separado, cada uno con sus propios ajustes operativos y costos.
Las fechas que marcan el despliegue
El lanzamiento de octubre de DeepSeek combina una actualización del modelo, una versión candidata de Harness y el acceso público a su infraestructura de búsqueda. Antes, el 17 de octubre, un rastreador automatizado de API detectó una entrada de modelo con el sufijo 1017 que luego desapareció. El anuncio posterior de DeepSeek confirmó el lanzamiento y la actualización en su sitio web, aplicación y API.
La secuencia deja a los desarrolladores un breve período para actualizar sus herramientas y examinar el uso de la búsqueda antes de que termine la ventana temporal gratuita:
- 10 de septiembre de 2026: DeepSeek lanza el modelo V4.1 Flash original.
- 3 de octubre de 2026: Harness v0.2.1-alpha.1 incorpora el puente experimental de Claude Code Mods.
- 17 de octubre de 2026: V4.1-Flash-1017 llega al sitio web, la aplicación y la API; Search y Fetch quedan disponibles para los desarrolladores, y se publica una versión candidata actualizada de Harness.
- 31 de octubre de 2026, a las 16:00 UTC: comienza la facturación de las llamadas a Search y Fetch que cumplan los requisitos y se realicen mediante herramientas de servidor; corresponde a la medianoche del 1 de noviembre en Pekín.
Quienes ya utilizan deepseek-flash recibirán el modelo actualizado con el nombre existente. A los usuarios de Harness se les recomienda actualizar también la aplicación que lo rodea. El cambio práctico es un flujo de trabajo más integrado: un modelo preparado para proyectos más largos, herramientas para realizar el trabajo y un servicio de búsqueda que pronto tendrá un cargo independiente por uso.
Puntos clave
- DeepSeek lanzó V4.1-Flash-1017 el 17 de octubre de 2026 en su sitio web, aplicación y API.
- El modelo sigue disponible como deepseek-flash; el método existente para llamar a la API del modelo y sus precios no cambian.
- DeepSeek informa de una puntuación de 77,0 en DeepSWE v1.1, frente a 74,2, además de tareas más rápidas y respuestas más breves.
- Las demostraciones de proyectos incluyen el modelado de la Ciudad Prohibida, un juego de carreras para navegador, una recreación de Portal 2 y Valley of Ages.
- Search y Fetch cuestan cada uno 0,75 dólares, o 5 yuanes según la tarifa china, por cada 1.000 llamadas satisfactorias.
- La facturación de las llamadas que cumplan los requisitos y se realicen mediante herramientas de servidor comienza el 1 de noviembre a la medianoche en Pekín.
- DeepSeek recomienda Harness v0.2.1-rc.1 o una versión posterior y publicó los pesos del modelo en Hugging Face y ModelScope.