Una pequeña computadora china de IA apunta a un rival más costoso
Sipeed apunta a un precio de unos 3.999 dólares para una computadora MaixStation con 128 GB de memoria, basada en el AX8860P del fabricante chino de chips Axera. El equipo propuesto mide apenas 11 por 11 por 3 cm y promete ejecutar grandes modelos de IA localmente con un consumo típico de 40 vatios. Su rival previsto es el DGX Spark de Nvidia, un sistema compacto de IA que cuesta unos 6.950 dólares con 128 GB.
Contenido
- Una pequeña computadora china de IA apunta a un rival más costoso
- Qué incluye el AX8860P de Axera
- Por qué 128 GB importan más que una cifra destacada de TOPS
- La página oficial de pruebas ofrece un panorama más acotado
- Por qué las afirmaciones de velocidad anteriores requieren una comparación cuidadosa
- Una caja de bolsillo con almacenamiento estándar
- Más chips prometen mayor capacidad, aunque el escalado aún es una afirmación
- La promesa del software es clave para el uso diario
- El precio y la entrega ahora dependen de una campaña
- Puntos clave
Axera presentó el chip en una exposición industrial en Shanghái el 13 de octubre de 2026, cuando Sipeed también dio a conocer MaixStation. La propuesta inicial fue llamativa: un procesamiento de indicaciones 25% más rápido y una generación de respuestas 30% más rápida que el DGX Spark al ejecutar un modelo Qwen de 27.000 millones de parámetros, por aproximadamente la mitad del precio.
La página del producto MaixStation de Sipeed ofrece ahora información más detallada. Indica una velocidad de 592 a 677 tokens por segundo para procesar indicaciones con Qwen3.8-27B y de 6 a 7 tokens por segundo para generar respuestas. Esas cifras son inferiores a los rangos difundidos en torno al anuncio, mientras que el plan oficial de lanzamiento prevé una campaña de Kickstarter a finales de 2026.
El atractivo es concreto: una gran cantidad de memoria en una computadora pequeña podría permitir a desarrolladores, oficinas y usuarios particulares ejecutar modelos potentes sin alquilar capacidad de computación en la nube ni comprar varias tarjetas gráficas. Sin embargo, la decisión de compra depende tanto del software definitivo, el rendimiento medido y el calendario de entrega como de las especificaciones del chip.
Qué incluye el AX8860P de Axera
La familia AX8860 utiliza un proceso de fabricación de 6 nanómetros y combina 16 núcleos de CPU Arm Cortex-A55 con una unidad de procesamiento neuronal dedicada, o NPU. Una NPU es un procesador diseñado para realizar los cálculos repetitivos que utilizan los modelos de IA. Axera y Sipeed le atribuyen un rendimiento de hasta 256 billones de operaciones por segundo, que suele expresarse como 256 TOPS, con FP4.
FP4 almacena valores numéricos con una precisión de cuatro bits. El uso de menos bits reduce la memoria necesaria para un modelo y puede acelerar los cálculos, aunque el modelo y el software deben admitir ese formato. La cifra de Axera corresponde a la computación densa, no a un cálculo que supone que algunos valores pueden omitirse mediante una técnica llamada dispersión.
El chip admite PCIe 5.0 y una interfaz de memoria de 256 bits de ancho. Sipeed especifica memoria LPDDR5X-8533, de hasta 128 GB por módulo, y un ancho de banda de 273 GB por segundo. Su módulo Maix-V mide 78 por 78 mm y utiliza un conector LPCAMM2.
Los núcleos Cortex-A55 se encargan del sistema operativo y de las tareas complementarias, mientras que la NPU está destinada a ejecutar la mayor parte de la carga de trabajo de IA. El DGX Spark de Nvidia tiene 20 núcleos Arm, incluidos los más potentes Cortex-X925, mientras que las computadoras Ryzen AI Halo de AMD utilizan CPU Zen 5. Por eso, quienes planean combinar la inferencia de IA con una cantidad considerable de computación convencional tienen más aspectos que comparar, además del acelerador.
Por qué 128 GB importan más que una cifra destacada de TOPS
Un modelo de lenguaje necesita memoria para sus pesos numéricos, que codifican lo aprendido durante el entrenamiento, y para los datos de trabajo que se generan mientras responde a una solicitud. Un acelerador rápido con poca memoria puede obligar a dividir el modelo entre varios dispositivos o trasladarlo a un almacenamiento más lento.
La configuración propuesta de 128 GB de MaixStation la sitúa en la misma categoría de capacidad de memoria que el DGX Spark, de mayor tamaño. Ambos indican un ancho de banda de 273 GB por segundo. La gama Ryzen AI Halo de AMD incluye una configuración con 128 GB y unos 256 GB por segundo, además de una versión más costosa con 192 GB y 273 GB por segundo.
La capacidad determina cuánto puede almacenarse. El ancho de banda determina con qué rapidez puede trasladarse la información al procesador. Durante la generación habitual de texto por parte de un modelo de lenguaje denso, producir cada nuevo token requiere leer grandes cantidades de datos del modelo. Un token es una pequeña unidad de texto: a veces una palabra y, otras, solo una parte.
Por eso, Sipeed sostiene que un uso eficaz de la memoria puede permitir que su procesador de 256 TOPS compita con la cifra de computación anunciada, más elevada, de Nvidia. La clasificación FP4 de unos 1.000 TOPS del DGX Spark utiliza dispersión; su cifra FP4 de computación densa es de unos 500 billones de operaciones por segundo. La velocidad real de una aplicación también depende de la eficiencia con que el software mantiene ocupado el hardware.
La página oficial de pruebas ofrece un panorama más acotado
Sipeed separa sus pruebas en prefill, cuando el modelo procesa la indicación del usuario, y decode, cuando genera una respuesta. Un prefill más rápido puede reducir la espera antes de que empiece la respuesta, sobre todo con documentos largos. Una mayor velocidad de decode hace que la respuesta aparezca más rápido una vez iniciada la generación.
Para Qwen3.8-27B en FP4 denso, la página oficial indica que MaixStation alcanza entre 592 y 677 tokens por segundo en prefill, frente a 550 del DGX Spark. Esto supone una ventaja de aproximadamente 8% a 23%. La velocidad de decode indicada para MaixStation es de 6 a 7 tokens por segundo, pero el texto disponible de la gráfica oficial no ofrece una cifra de referencia para el decode del DGX Spark con ese modelo.
Para Qwen3.6-35B-A3B, un modelo de mezcla de expertos, Sipeed indica un prefill de 2.664 a 3.256 tokens por segundo, frente a 2.368 del DGX Spark. La ventaja calculada es de aproximadamente 13% a 38%. La velocidad de decode es de 34 a 37 tokens por segundo, frente a 34, lo que supone desde un empate hasta una ventaja de aproximadamente 9%.
Un modelo de mezcla de expertos activa solo una parte de su red para cada token. Esto ayuda a explicar por qué su velocidad de generación puede ser mucho mayor que la de un modelo denso con una cantidad total de parámetros similar. Ambos tipos de modelo requieren distintas cantidades de trabajo por token.
Sipeed describe los resultados publicados como mediciones actuales conservadoras y afirma que sigue ajustando el AX8860P. La gráfica especifica FP4 con la predicción de múltiples tokens, o MTP, desactivada. MTP es una técnica que propone varios tokens futuros a la vez para acelerar la generación.
Por qué las afirmaciones de velocidad anteriores requieren una comparación cuidadosa
Los rangos de referencia que Sipeed publicó antes eran más altos: de 1.400 a 1.600 tokens por segundo en prefill y de 15 a 17 en decode para Qwen3.8-27B, frente a cifras de referencia de 1.300 y 13 para el DGX Spark. Para el modelo de mezcla de expertos, esos rangos eran de 6.300 a 7.700 en prefill y de 80 a 88 en decode, frente a 5.600 y 80. Sipeed también publicó después una comparación que situaba a MaixStation cerca de 10% por delante en ambas etapas y señaló que las pruebas más recientes que mostraban una ventaja mayor no eran oficiales.
Las cifras absolutas más bajas de la página oficial hacen especialmente relevantes las condiciones de las pruebas. La longitud de las indicaciones, la cantidad de solicitudes procesadas simultáneamente, los formatos numéricos, el software de ejecución y las versiones de los controladores pueden cambiar los resultados. Pruebas independientes del DGX Spark citadas en la cobertura alcanzaron unos 11,5 a 11,6 tokens por segundo con Qwen3.8-27B sin decodificación especulativa, mientras que el prefill osciló entre 840 y 1.900, según el software.
Un cálculo sencillo de memoria explica la atención que recibió la afirmación anterior de 17 tokens por segundo. Si el modelo en ejecución ocupa aproximadamente 16 GB, dividir 273 GB por segundo entre 16 GB da unos 17 tokens por segundo, antes de tener en cuenta el tráfico adicional de memoria. Alcanzar esa velocidad exigiría aprovechar de manera excepcionalmente alta el ancho de banda anunciado.
La cantidad de memoria que ocupa realmente el modelo es importante. Cuatro bits multiplicados por 27.000 millones de parámetros equivalen a unos 13,5 GB solo para los pesos, mientras que los datos de escala numérica y otros elementos de almacenamiento pueden aumentar el tamaño de trabajo. Las pruebas detalladas y reproducibles permitirían a los compradores relacionar las cifras de velocidad con una configuración específica del modelo.
Una caja de bolsillo con almacenamiento estándar
Las dimensiones anunciadas de MaixStation corresponden a un volumen de 363 centímetros cúbicos. Sipeed lo compara con los 1.125 centímetros cúbicos del DGX Spark, de modo que la carcasa propuesta ocuparía aproximadamente un tercio de ese volumen. La empresa afirma que el equipo puede recibir alimentación por USB-C desde una batería externa adecuada, con una potencia nominal de 65 vatios.
La página oficial indica un consumo típico de 40 vatios para MaixStation y de 120 vatios para el DGX Spark. Esas son las cargas típicas que señala Sipeed. La cobertura inicial del AX8860 también especificó 40 vatios para el módulo dedicado, por lo que el alcance de las mediciones de consumo será otro dato útil para las pruebas futuras.
Las conexiones incluyen redes 10G SFP+, USB-C, un conector MCIO 8i y una ranura M.2 2280 estándar para una unidad SSD. Ese formato de almacenamiento ofrece a los compradores una forma conocida de ampliar el espacio para archivos de modelos, que pueden consumir rápidamente cientos de gigabytes.
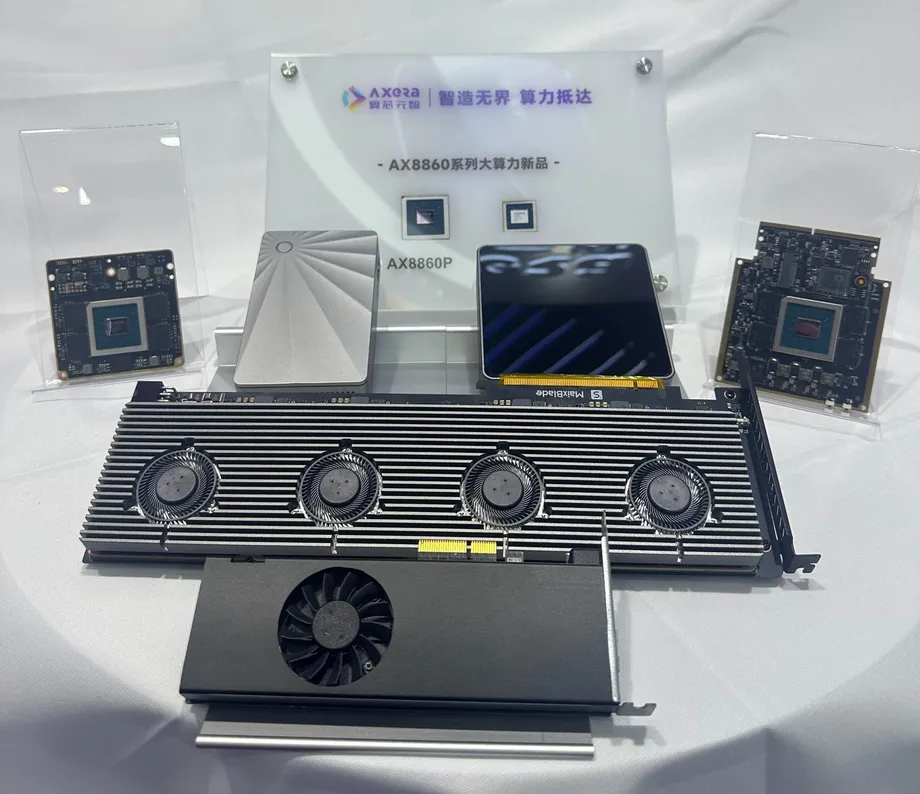
Los planes de hardware de Axera van más allá de la computadora de escritorio pequeña. Incluyen un módulo, una tarjeta PCIe con un chip y otra tarjeta con cuatro chips, cuatro ventiladores y un conector de alimentación estándar de ocho pines. Sipeed asocia MaixStation Pro y MaixBlade con configuraciones que ofrecen 512 GB o más.
Más chips prometen mayor capacidad, aunque el escalado aún es una afirmación
Sipeed afirma que MaixStation puede conectar hasta ocho nodos sin un conmutador externo, mediante una conexión entre chips con una velocidad nominal de 256 gigabits por segundo, ampliable a 384 gigabits por segundo. El DGX Spark utiliza una conexión de 200 gigabits para enlazar sistemas, y una configuración con cuatro unidades Spark requiere un conmutador externo.
Es importante distinguir entre gigabits y gigabytes. Una conexión con una velocidad nominal de 256 gigabits por segundo equivale a una velocidad bruta de 32 gigabytes por segundo, antes de descontar la sobrecarga. El ancho de banda de memoria de 273 gigabytes por segundo describe una conexión diferente y mucho más rápida dentro de cada equipo.
Axera indica que dos chips alcanzan un total de 512 TOPS y cuatro, de 1.024 TOPS, junto con una afirmación de eficiencia de escalado de aproximadamente 80%. La cifra de escalado con cuatro chips procede de una simulación de laboratorio. Dividir un modelo entre procesadores también genera trabajo de comunicación y sincronización, por lo que la velocidad de las aplicaciones depende de algo más que sumar sus capacidades máximas de computación.
La hoja de ruta de Axera menciona un AX8950 con un rendimiento de hasta 500 TOPS y un AX8970 que supera los 700 TOPS. Esos procesadores previstos ofrecerían opciones de actualización posteriores, pero la propuesta inmediata de MaixStation depende del AX8860P y su software.
La promesa del software es clave para el uso diario
Sipeed menciona Debian 13 con Linux 6.18, junto con la compatibilidad con vLLM, SGLang, PyTorch, llama.cpp y Ollama. Estas herramientas ayudan a cargar modelos, atender solicitudes y conectar aplicaciones de IA con el hardware. La empresa también anuncia API compatibles con OpenAI y Anthropic, para que las aplicaciones existentes puedan enviar solicitudes a un dispositivo local.
La sección de preguntas frecuentes del producto de Sipeed explica que los nombres conocidos de los marcos de trabajo se apoyan en software escrito para el hardware de Axera:
SGLang y vLLM funcionan mediante un sistema personalizado de aceleración por hardware, cuyos núcleos están escritos en AXDSL.
Los núcleos son pequeños componentes de software que realizan cálculos esenciales en el acelerador. Sipeed afirma que los usuarios pueden cargar directamente los modelos compatibles de Hugging Face, mientras que las nuevas arquitecturas de modelos podrían requerir núcleos escritos en AXDSL. La empresa promete publicar los núcleos y las herramientas de desarrollo, y afirma que trabaja para abrir el kit de desarrollo de software del AX8860.
La empresa anuncia que los modelos y una interfaz para navegador estarán listos desde el inicio. Entre los usos que propone figuran agentes de programación, procesamiento de documentos, generación de video y robótica. Primero habrá equipos anfitriones Linux para las tarjetas PCIe; la compatibilidad con Windows dependerá de la demanda. En el momento del anuncio, se esperaba que la cadena de herramientas de la NPU estuviera disponible a finales de octubre.
El precio y la entrega ahora dependen de una campaña
El precio previsto por Sipeed de 3.999 dólares para 128 GB sería unos 2.951 dólares, o 42%, inferior al precio de 6.950 dólares del DGX Spark. Es un descuento considerable, aunque no llega a la mitad. También situaría a MaixStation cerca del precio de unos 3.999,99 dólares de una AMD Ryzen AI Halo con 128 GB.
El calendario de lanzamiento ha cambiado respecto de la previsión inicial de que los equipos llegarían durante 2026. Ya se aceptan reservas, pero las preguntas frecuentes oficiales sitúan Kickstarter a finales de 2026. Sipeed ha dicho que prevé comenzar los envíos en los tres meses posteriores al cierre de la campaña.
- 13 de octubre de 2026: Axera presentó la familia AX8860 en Shanghái y Sipeed dio a conocer MaixStation.
- Finales de octubre de 2026: Sipeed esperaba que estuviera disponible la cadena de herramientas de la NPU.
- Finales de 2026: Sipeed prevé lanzar su campaña de Kickstarter para MaixStation.
- En los tres meses posteriores al cierre de la campaña: plazo de envío indicado por Sipeed.
Sipeed no ha confirmado el precio minorista definitivo, una fecha firme de entrega ni el rendimiento de MaixStation mediante pruebas independientes. También siguen sin definirse la capacidad de producción, las condiciones de asistencia y el precio y el calendario de la versión Pro de 512 GB. Durante la campaña están previstos el acceso remoto y el envío de unidades para reseñas, lo que ofrecerá a los posibles compradores una nueva oportunidad para evaluar las afirmaciones.
Puntos clave
- MaixStation apunta a unos 3.999 dólares por 128 GB de memoria y un procesador Axera AX8860P con una capacidad nominal de 256 TOPS en FP4 denso.
- Sipeed indica un ancho de banda de memoria de 273 GB por segundo, un consumo típico de 40 vatios y una carcasa de 11 por 11 por 3 cm.
- La página oficial de pruebas muestra velocidades absolutas inferiores a los rangos publicados anteriormente, con resultados que varían según el modelo y la etapa de procesamiento.
- La compatibilidad con software depende de un sistema personalizado de aceleración de Axera, y la empresa promete publicar herramientas de desarrollo y más código.
- La campaña de Kickstarter está prevista para finales de 2026, seguida de un plazo de envío indicado de hasta tres meses desde su cierre.
- Las pruebas independientes, los precios definitivos y los compromisos de entrega determinarán cómo se compara el sistema propuesto con las alternativas de Nvidia y AMD.