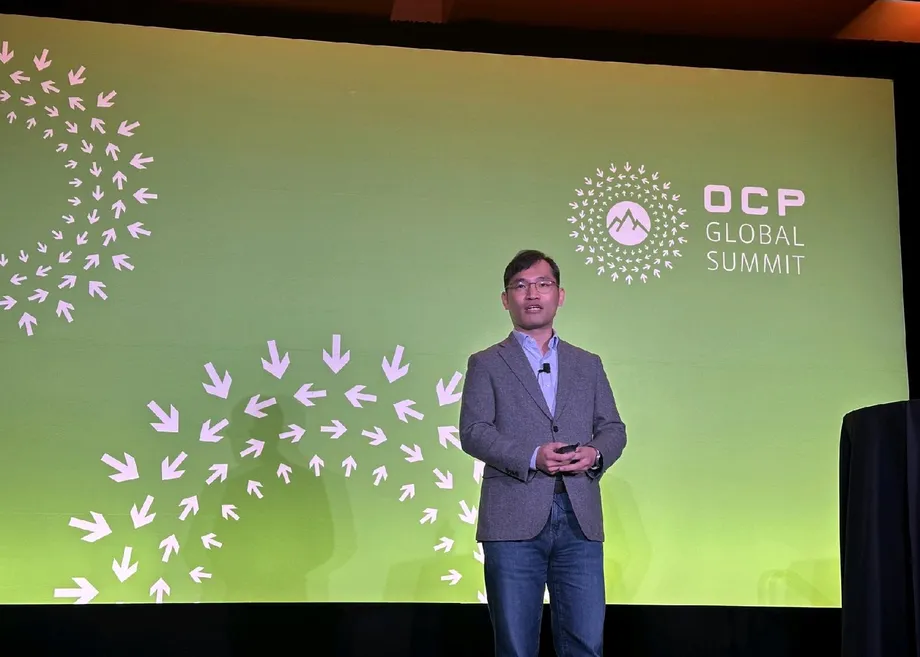
Samsung incorpora la capacidad de memoria junto con la velocidad de procesamiento
Samsung Electronics amplía su estrategia de infraestructura de IA más allá de la memoria de alto ancho de banda, al combinar HBM5 y memoria personalizada con una colaboración con AMD en tecnologías de memoria compartida para servidores y almacenamiento que trasladan parte del procesamiento de datos a las unidades SSD. La empresa presentó este enfoque en la Cumbre Global OCP 2026, prevista del 12 al 15 de octubre en el Centro de Convenciones McEnery de San José, California.
Contenido
- Samsung incorpora la capacidad de memoria junto con la velocidad de procesamiento
- HBM5 encabeza una estrategia más amplia de velocidad
- La colaboración con AMD busca ampliar la capacidad de memoria de forma flexible
- La caché KV conecta la ampliación de memoria con el almacenamiento
- Las unidades SSD asumen funciones de capacidad, refrigeración y ubicación de datos
- Acercar el procesamiento a los datos almacenados
- Las pruebas con clientes y las muestras de fabricación amplían la propuesta
- Una alianza desarrollada a lo largo de varios meses
- La dimensión del mercado no determina la preparación comercial
- Puntos clave
Las afirmaciones de rendimiento más concretas se refieren a tecnologías de otros niveles de la jerarquía de memoria. Samsung informa de una reducción de hasta el 38% en el tiempo que tarda un modelo de IA en generar su primer token mediante la asignación elástica de memoria CXL, un rendimiento de inferencia hasta tres veces mayor con procesamiento en memoria LPDDR5X y velocidades de lectura secuencial de SSD de hasta 28,4 GB/s. Se trata de resultados de evaluaciones o demostraciones específicas, no de garantías para todas las instalaciones de IA.
La página oficial de la cumbre organiza su estrategia en torno a la velocidad, la ampliación de memoria y la persistencia. Entre los productos destacados figuran HBM4E, LPDDR5X-PIM, el módulo de memoria CMM-D MD310, la memoria para servidores SOCAMM2 y las unidades SSD PM1763 y BM1773.
Hojun Shim, identificado por Samsung como vicepresidente corporativo y responsable del Equipo de Ingeniería de Aplicaciones del negocio de memoria, tenía previsto presentar las tres prioridades en una sesión ejecutiva el 12 de octubre. Según las informaciones, la presentación marca el inicio de una iniciativa más amplia para optimizar conjuntamente los procesadores, la memoria y el almacenamiento, en lugar de mejorar cada componente por separado.
La diferencia es importante durante la inferencia, cuando un modelo entrenado genera respuestas. Un acelerador rápido puede tener que esperar a que lleguen los datos, quedarse sin memoria a medida que se prolongan las conversaciones o sufrir demoras al recuperar información del almacenamiento. Samsung propone tecnologías distintas para cada una de esas limitaciones.
HBM5 encabeza una estrategia más amplia de velocidad
Según las informaciones sobre la exposición, entre las iniciativas de Samsung para mejorar la velocidad figuran HBM5, descrita como memoria de alto ancho de banda de octava generación, la HBM personalizada y zHBM. La memoria de alto ancho de banda suministra grandes cantidades de datos a un acelerador mediante numerosas conexiones paralelas. Las versiones personalizadas buscan adaptarse a los requisitos de los sistemas de cada cliente.
La lista oficial de productos menciona HBM4E, no HBM5. Otros informes describen maquetas conceptuales de HBM4E y HBM5 en la exposición. La diferencia es importante: mostrar un producto o presentar un concepto no significa que ya esté a la venta, y la página de la cumbre de Samsung no indica una fecha de lanzamiento comercial de HBM5 ni especificaciones detalladas de rendimiento.
La evidencia numérica más sólida sobre velocidad de procesamiento corresponde a LPDDR5X-PIM. El procesamiento en memoria realiza parte de los cálculos dentro del dispositivo de memoria, lo que reduce las transferencias repetidas entre la memoria y un procesador independiente. Samsung afirma que su diseño integra unidades de procesamiento en cada banco de memoria.
En una evaluación con Llama 3.1 8B en el acelerador de IA Edge de Samsung, la empresa informa de un ancho de banda efectivo hasta ocho veces mayor que el de LPDDR5X convencional, hasta tres veces más tokens generados por segundo y un tiempo de ejecución hasta 2,2 veces menor. Estas cifras corresponden a ese acelerador y ese modelo, no a HBM5 ni a la demostración de memoria con AMD.
SOCAMM2, también presentado, es un módulo de memoria para servidores basado en LPDDR. En conjunto, las muestras muestran que la estrategia de velocidad de Samsung incluye tanto memoria para aceleradores como tecnologías de memoria de menor consumo, aunque la página de la cumbre no ofrece resultados comparables de pruebas de rendimiento para todos los productos.
La colaboración con AMD busca ampliar la capacidad de memoria de forma flexible
Samsung y AMD demostraron la ampliación de memoria CXL mediante la tecnología CMM-D de Samsung. CXL, sigla de Compute Express Link, conecta procesadores y otros dispositivos con memoria adicional, lo que permite ampliar la capacidad de los sistemas más allá de la memoria instalada directamente en ellos.
CMM-D es un módulo de memoria DRAM basado en CXL. En una configuración agrupada, varios sistemas pueden utilizar la capacidad de los recursos de memoria conectados, en lugar de dejarla asignada de forma permanente a servidores individuales. Samsung afirma que su colaboración con AMD validó CXL como una forma de ampliar la capacidad y el ancho de banda de memoria, y reducir los períodos en que los núcleos de CPU esperan datos.
El problema se agrava a medida que los agentes de IA ejecutan varios modelos o tareas. Según la descripción oficial de Samsung, las cargas de trabajo de agentes pueden aumentar considerablemente el uso de CPU mientras la capacidad de memoria no crece al mismo ritmo que el número de núcleos de procesamiento.
En otra demostración de agrupación CMM-D se utilizó la asignación elástica entre varias instancias de modelos de lenguaje de gran tamaño en un servidor con GPU. Samsung informa de una reducción de hasta el 38% en el tiempo hasta el primer token (TTFT) y un rendimiento útil hasta 3,3 veces mayor que con la asignación estática. El TTFT mide la espera antes de que comience una respuesta; el rendimiento útil mide el trabajo efectivo realizado según los criterios de la evaluación.
Estos resultados no deben interpretarse como cifras de la propia demostración con AMD. La página oficial describe por separado la validación con AMD y la prueba de asignación elástica. Tampoco ofrece suficientes detalles para establecer cómo cambiarían las mejoras con otros modelos, configuraciones de servidores o objetivos de servicio.
La caché KV conecta la ampliación de memoria con el almacenamiento
Un vínculo central entre los planes de memoria y almacenamiento de Samsung es la caché de claves y valores, conocida normalmente como caché KV. Esta conserva información intermedia generada cuando un modelo de lenguaje procesa texto, lo que permite reutilizar cálculos en lugar de repetirlos con cada nuevo token.
Las conversaciones largas, los contextos más amplios y varios usuarios simultáneos pueden hacer que estas cachés ocupen mucha memoria. Samsung propone una jerarquía en la que la memoria CXL amplía la capacidad disponible y las unidades SSD almacenan los datos de caché que no necesitan permanecer en el nivel de memoria más rápido.
La página oficial de la cumbre describe una implementación en producción en el campus estadounidense de Samsung Semiconductor, que da servicio a un agente interno de programación con IA y otras aplicaciones. Samsung afirma que añadir un nivel de memoria componible L3.5 mediante su solución AI Memory Node permitió multiplicar por cinco a siete el aprovechamiento de la caché KV.
L3.5 es el nombre que se da a ese nivel adicional, no una afirmación de que todos los servidores compartan una arquitectura de caché idéntica. En la implementación participaron el Laboratorio de Soluciones de Memoria de Samsung, su equipo de Integración de Plataformas de IA DSA y SGLang. El resultado de aprovechamiento es distinto tanto de la prueba de asignación elástica como de las cifras de rendimiento de LPDDR5X-PIM.
El programa de la cumbre también incluyó una sesión el 13 de octubre sobre la combinación de la agrupación CXL con el almacenamiento SSD para trasladar la caché KV, presentada por el arquitecto de sistemas Jinin So y el ingeniero principal Youngha Choi. Esa combinación convierte la estrategia en algo más que una ampliación de capacidad: requiere software que ubique y recupere datos en la memoria y el almacenamiento sin introducir demoras excesivas.
Las unidades SSD asumen funciones de capacidad, refrigeración y ubicación de datos
La estrategia de persistencia de Samsung se centra en las unidades SSD empresariales y la memoria flash NAND de alta capacidad. La persistencia consiste en conservar los datos más allá del estado de trabajo temporal de un cálculo, de modo que los sistemas de IA puedan recuperar conjuntos de datos, archivos de modelos e información de caché guardada cuando la necesiten.
La PM1763 se presenta como una unidad SSD empresarial PCIe Gen6 con velocidades de lectura secuencial de hasta 28,4 GB/s y una eficiencia energética hasta 1,8 veces mayor que la de su predecesora. En la demostración de refrigeración líquida, la versión E1.S está en contacto directo con una placa fría para disipar el calor. La página oficial no proporciona todas las condiciones de prueba de la comparación de rendimiento.
La BM1773 figura como una unidad SSD E3.S con 256 TB de almacenamiento QLC. QLC, o celda de cuatro niveles, almacena cuatro bits en cada celda flash y permite alcanzar una gran capacidad. Los informes también describen el desarrollo continuo por parte de Samsung de memoria flash QLC de alta capacidad y tecnología flexible de ubicación de datos.
Samsung presentó optimizaciones de caché KV integradas en LMCache. La ubicación flexible de datos, o FDP, ayuda a organizar dónde se escriben los datos para reducir la amplificación de escritura, es decir, las escrituras internas adicionales que realiza una unidad SSD más allá de los datos enviados por el sistema anfitrión.
La demostración también utiliza un tamaño máximo de transferencia de datos de NVMe mayor para reducir el trabajo de la CPU del sistema anfitrión. Samsung describe estas técnicas como útiles tanto para almacenar caché en un único nodo como para compartir recursos de caché entre un grupo de servidores. La página del evento no ofrece cifras de mejora para estas optimizaciones concretas.
Acercar el procesamiento a los datos almacenados
La demostración de base de datos vectorial de Samsung ofrece otra forma de reducir el movimiento de datos. Las bases de datos vectoriales almacenan representaciones numéricas de información y las comparan para encontrar elementos similares, un paso habitual cuando una aplicación de IA recupera documentos pertinentes para una solicitud.
La prueba de concepto NCVS traslada a las unidades SSD los cálculos de distancia vectorial. En lugar de enviar un vector de 4 KB al sistema anfitrión para compararlo, el dispositivo devuelve un resultado de distancia de cuatro bytes. Samsung informa de un tráfico del sistema anfitrión hasta 22 veces menor que con la vía convencional de procesamiento en el anfitrión, y de un aumento del rendimiento de búsqueda al añadir más unidades SSD.
Las cifras de cuatro bytes y 4 KB describen el tamaño de los resultados y los vectores individuales; no significan que la aplicación completa reduzca el tráfico en la misma proporción. La reducción informada de hasta 22 veces corresponde a la comparación general medida. Samsung identifica NCVS como una prueba de concepto, no como un producto disponible de forma general.
Su demostración AiSIO aborda las operaciones de entrada y salida del almacenamiento mediante una interfaz de software común para operaciones iniciadas por la GPU, entre pares y las iniciadas convencionalmente por la CPU. Samsung informa de 100 millones de operaciones de entrada y salida por segundo y una carga de modelos de lenguaje desde un inicio en frío hasta diez veces más rápida mediante OpenDS.
Estas mediciones corresponden a tareas diferentes. La velocidad de lectura secuencial mide la transferencia sostenida de datos, las operaciones de entrada y salida por segundo cuentan las solicitudes al almacenamiento y la carga desde un inicio en frío mide cuánto tarda un modelo en estar listo. Ninguna sustituye directamente a una prueba que muestre cuántas solicitudes de usuarios puede atender un servicio de IA completo.
Las pruebas con clientes y las muestras de fabricación amplían la propuesta
Samsung MAX Lab busca incorporar antes a los clientes al proceso de desarrollo. Estos pueden probar tecnologías como PIM, CMM-D y unidades SSD de próxima generación antes de su comercialización, con cargas de trabajo de IA realistas, y aportar después sus requisitos de sistema al diseño de los productos.
Este enfoque responde a una cuestión práctica que se repite en las demostraciones de la cumbre: un componente más rápido solo aporta valor si el software y el hardware que lo rodean pueden aprovecharlo. El Equipo de Ecosistema Abierto Global de Samsung participa en el desarrollo de software de código abierto y la estandarización del sector, mientras que el programa del evento incluye sesiones sobre marcos de software, gestión de comandos de almacenamiento y administración de memoria.
Samsung también presentó almacenamiento componible con migración en vivo y gestión virtual de unidades SSD a través de NVMe estándar. En su descripción oficial, esto se plantea como una vía para compartir almacenamiento entre varios usuarios, con una calidad de servicio exigible, es decir, controles sobre el servicio que recibe cada carga de trabajo.
La exposición fue más allá de la memoria. Según los informes, incluyó obleas de unidades de procesamiento de lenguaje de Groq fabricadas con el proceso de 4 nm de Samsung Foundry, un sistema Groq 3 LPX descrito en varios informes como un sistema de Nvidia y obleas producidas con el proceso gate-all-around de 2 nm de Samsung. Estas muestras presentan capacidades de fabricación junto con la memoria y el almacenamiento, pero no confirman nuevos contratos de producción ni volúmenes de envío.
Una alianza desarrollada a lo largo de varios meses
La demostración con AMD se enmarca en una cooperación previa. Según los informes, en marzo ambas empresas firmaron un memorando de entendimiento sobre tecnologías de memoria y computación de IA de próxima generación; después, mantuvieron conversaciones durante la visita a Corea del Sur de Lisa Su, directora ejecutiva de AMD, el 7 de octubre.
La secuencia de los acontecimientos y las sesiones programadas para la cumbre, según los informes, es la siguiente:
- Marzo de 2026: Samsung y AMD firmaron su memorando de cooperación; Samsung también presentó tecnología en Nvidia GTC.
- Junio y agosto de 2026: Samsung hizo presentaciones en COMPUTEX y en la conferencia Future of Memory and Storage, respectivamente.
- 7 de octubre de 2026: Lisa Su visitó Corea del Sur y se reunió con Jeon Young-hyun, vicepresidente de la División DS de Samsung, para hablar de cooperación en memoria y computación; según los informes, también se abordaron asuntos de fabricación.
- 12 de octubre de 2026: comenzó la cumbre y ese día estaba programada la presentación ejecutiva de Shim.
- Del 13 al 15 de octubre de 2026: el programa de Samsung incluyó sesiones sobre organización por niveles de la caché KV, optimización del almacenamiento y arquitectura de memoria CXL compartida.
Samsung participó como patrocinador Diamante. Los informes difieren en si la fecha del anuncio de la estrategia fue el 12 de octubre, hora local, o el comunicado de la empresa del 13 de octubre. Ambas fechas pueden corresponder a distintas etapas del mismo evento. Una fuente sitúa la cumbre en San Francisco, mientras que el programa oficial de Samsung indica que se celebra en el centro de convenciones de San José.
La dimensión del mercado no determina la preparación comercial
Según estudios del sector citados en los informes, Samsung ocupó el primer puesto en el segundo trimestre de 2026, con el 39% de los ingresos mundiales por DRAM y el 29,3% del mercado de memoria flash NAND. Counterpoint Research aparece como fuente de la cifra de DRAM y TrendForce, de la cifra de NAND. Se trata de cuotas de mercado, no de participación en los mercados emergentes de CXL o de procesamiento en memoria.
Se cita a Omdia como fuente de una previsión según la cual Samsung tendrá durante el año la mayor producción de obleas DRAM y NAND del sector. Otra estimación sitúa su capacidad anual de DRAM en unos 8,175 millones de obleas equivalentes a obleas de 300 mm. La capacidad no equivale a la producción real y ninguna de las dos cifras establece qué proporción se destina a las tecnologías presentadas en OCP.
Un informe también ofrece cifras preliminares inusualmente elevadas para el tercer trimestre, con fecha del 8 de octubre: ingresos de 195 billones de wones y un beneficio operativo de 107,4 billones de wones, un 782,5% más que un año antes. Estas cifras no están respaldadas aquí por un comunicado financiero oficial y no deben considerarse pruebas confirmadas de ingresos derivados de las tecnologías presentadas en la cumbre.
La competencia también se extiende más allá de HBM. Según los informes, el sistema de bastidor de IA centrado en memoria de SK hynix, llamado MARS, utiliza un conjunto de memoria CXL compartido en todo un bastidor. Este enfoque es similar al intento de Samsung de permitir que varios sistemas accedan a la memoria disponible, aunque no hay pruebas comparables que permitan establecer cuál ofrece mejores resultados.
Samsung afirma que busca reforzar su competitividad en HBM, DDR5 para servidores y unidades SSD empresariales. Entre los aspectos comerciales aún por aclarar figuran la disponibilidad de HBM5, los precios, una adopción más amplia por parte de los clientes y la confirmación independiente de las afirmaciones de rendimiento. El programa de la cumbre ofrece fechas de demostraciones y debates, no plazos firmes de lanzamiento para todas las tecnologías.
Puntos clave
- La estrategia de Samsung para OCP 2026 combina memoria más rápida, ampliación de capacidad mediante CXL y almacenamiento persistente en unidades SSD.
- La colaboración con AMD utiliza la tecnología de memoria CMM-D para responder a las crecientes necesidades de memoria de la IA.
- Una demostración independiente de agrupación elástica informa de una reducción de hasta el 38% en el tiempo hasta el primer token y un rendimiento útil 3,3 veces mayor.
- Las evaluaciones de LPDDR5X-PIM incluyen un rendimiento de inferencia hasta tres veces mayor en el acelerador de IA Edge de Samsung.
- El almacenamiento PM1763, la optimización de la caché KV y el procesamiento dentro de las unidades SSD apuntan a distintas limitaciones en el movimiento de datos.
- La información de la cumbre no confirma fechas de envío de HBM5 ni su disponibilidad comercial general.