El fabricante de teléfonos que acaba de cambiar la inferencia de IA
Un lunes por la mañana que sorprendió a la industria tecnológica, Xiaomi hizo algo que pocos observadores esperaban. La empresa, conocida sobre todo por sus teléfonos inteligentes asequibles, sus patinetes eléctricos y sus purificadores de aire para el hogar, anunció que había superado una barrera importante en la velocidad de la inteligencia artificial. Su nuevo modo de servicio MiMo-V2.5-Pro-UltraSpeed genera más de 1.000 tokens por segundo en un modelo de un billón de parámetros y alcanza un máximo cercano a los 1.200 tokens en demostraciones en directo. No se trata de una versión reducida del modelo. Es el modelo insignia completo MiMo-V2.5-Pro, un sistema de IA de vanguardia que rivaliza con Claude Opus en pruebas de programación.
Contenido
- El fabricante de teléfonos que acaba de cambiar la inferencia de IA
- Qué significa realmente generar 1.000 tokens por segundo
- Cómo Xiaomi superó a los gigantes de los chips personalizados
- Las tres técnicas que impulsan UltraSpeed
- Por qué la velocidad abre la puerta a aplicaciones completamente nuevas
- Acceso, precios y publicación de código abierto
- El discreto ascenso de Xiaomi como potencia de la IA
- En síntesis
Lo sorprendente del anuncio no es solo la velocidad, sino también el hardware que la hace posible. Xiaomi consiguió estas cifras con un único nodo estándar equipado con ocho GPU comerciales, un tipo de equipo disponible en cualquier gran proveedor de servicios en la nube. No utiliza silicio personalizado ni chips especializados del tamaño de un plato. Solo innovaciones de software que funcionan en hardware que los desarrolladores pueden alquilar hoy mismo.
Los parámetros son los pesos numéricos internos que determinan cómo procesa la información un modelo de IA. Un billón de parámetros significa que el modelo puede reconocer patrones extraordinariamente complejos en textos y código. Los tokens son fragmentos de texto que el modelo lee y genera; cada uno equivale aproximadamente a tres cuartas partes de una palabra. Generar más de 1.000 por segundo significa que este enorme cerebro funciona a un ritmo que antes se consideraba imposible sin hardware especializado.
Durante años, la carrera por acelerar la inferencia de IA estuvo dominada por empresas emergentes de chips con abundante financiación y diseños de silicio personalizado. Xiaomi acaba de demostrar que la ingeniería inteligente aplicada a equipos estándar puede dejarlas atrás. Este logro plantea una pregunta directa: ¿es necesario un costoso hardware especializado si la optimización inteligente del software puede ofrecer mejores resultados en infraestructuras accesibles?
Qué significa realmente generar 1.000 tokens por segundo
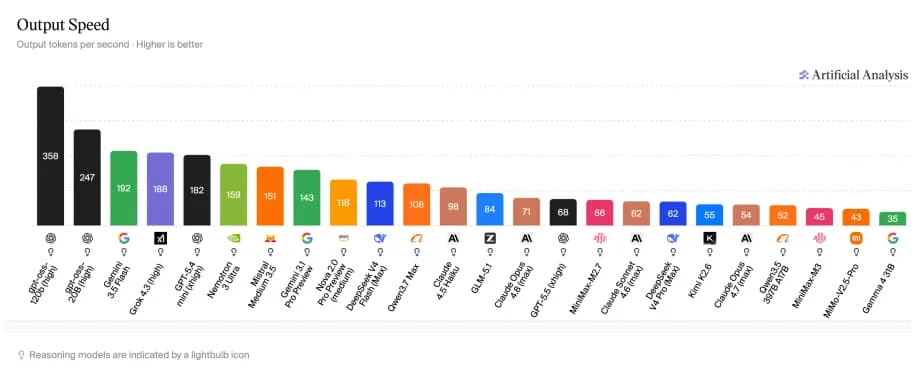
Para entender por qué importa esta cifra, basta con observar la experiencia cotidiana de los usuarios. Según los datos de referencia de Artificial Analysis, GPT-5.5, el modelo que impulsa la mayoría de las conversaciones en ChatGPT, genera aproximadamente 68 tokens por segundo. Claude Opus 4.6 funciona a unos 71 tokens por segundo, mientras que Haiku, el modelo más ligero de Anthropic, alcanza los 98. Gemini Flash, de Google, es más rápido y genera 192 tokens por segundo. MiMo-V2.5-Pro-UltraSpeed llega a los 1.000 tokens por segundo con un modelo de un billón de parámetros: casi quince veces más rápido que los chatbots que millones de personas usan a diario.
La diferencia entre 68 y 1.000 no es un simple avance gradual. Representa una categoría de rendimiento completamente distinta. A las velocidades actuales de los servicios para consumidores, los usuarios esperan varios segundos para que aparezca un párrafo. A la nueva velocidad de Xiaomi, una página completa de análisis puede generarse casi al instante. Para los desarrolladores que ejecutan agentes de programación, la diferencia transforma la experiencia: pasa de un intercambio con demoras a algo parecido a una colaboración en tiempo real.
Los tokens son la unidad básica de los modelos de lenguaje grandes. Cuando usted escribe una instrucción, el modelo divide el texto en tokens para procesarlo. Al responder, genera los tokens uno por uno y predice cada uno a partir de todo lo anterior. Cuanto más rápido genera tokens un modelo, más ágil resulta y más tareas puede completar dentro de límites de tiempo estrictos. La velocidad también determina cuántas solicitudes puede atender simultáneamente un servidor, lo que afecta directamente los costos y la capacidad de ampliación de las empresas.
La versión Flash anterior de MiMo-V2.5-Pro ya generaba respuestas a 150 tokens por segundo, unos 110 términos por segundo, más rápido de lo que puede leer o hablar incluso la persona más veloz. UltraSpeed eleva drásticamente ese límite y alcanza una tasa de generación que supera la capacidad de procesamiento humano y permite flujos de trabajo automatizados que antes eran imposibles.
Cómo Xiaomi superó a los gigantes de los chips personalizados
El cuello de botella de la velocidad de inferencia de IA ha atraído cientos de millones de dólares en inversiones de empresas que desarrollan hardware especializado. Cerebras diseñó un chip a escala de oblea, de un tamaño aproximado al de un plato, con 44 GB de memoria integrada para eliminar las limitaciones de ancho de banda. Ese diseño alcanzó los 969 tokens por segundo, un logro notable, pero con Llama 3.1 405B, de Meta, un modelo de 405.000 millones de parámetros. Es menos de la mitad del tamaño de MiMo-V2.5-Pro. Groq desarrolló una arquitectura personalizada de unidad de procesamiento de lenguaje capaz de generar entre 300 y 750 tokens por segundo, según el modelo. Ninguno de los dos sistemas funciona con el hardware estándar en la nube que los desarrolladores pueden alquilar a proveedores como AWS.
El enfoque de Xiaomi invierte por completo ese modelo. En colaboración con su socio de inferencia TileRT, la empresa alcanzó su récord mediante lo que denomina codesarrollo extremo entre modelo y sistema, una optimización coordinada tanto del modelo de IA como del motor de software que lo ejecuta. El resultado es un modelo de un billón de parámetros que funciona más rápido que el silicio especializado en GPU comerciales. Si pruebas independientes confirman estas cifras, el logro indicaría que la innovación de software puede superar limitaciones de hardware que muchos consideraban insalvables sin chips personalizados.
Este avance tiene importantes consecuencias económicas. El silicio personalizado requiere un gasto de capital enorme, largos ciclos de diseño y fabricación especializada. Las GPU comerciales se benefician de las economías de escala, la amplia disponibilidad y las constantes mejoras graduales de NVIDIA y otros fabricantes. Al resolver el problema de la inferencia mediante software, Xiaomi podría haber democratizado el acceso a velocidades que antes estaban reservadas para laboratorios bien financiados con hardware propio.
La publicación del punto de control FP4-DFlash en Hugging Face añade otra dimensión a esta democratización. Investigadores y desarrolladores de todo el mundo pueden ahora examinar, probar y adaptar el modelo subyacente sin comprar hardware propio ni obtener licencias empresariales. La validación de la comunidad determinará si estas técnicas pueden aplicarse ampliamente a otros modelos y casos de uso.
Las tres técnicas que impulsan UltraSpeed
El avance se basa en tres técnicas coordinadas que funcionan en conjunto. Ninguna logra por sí sola el récord de velocidad, pero, combinadas, superan el umbral de los 1.000 tokens.
La primera técnica es la cuantización FP4. La mayoría de los modelos grandes funciona con una precisión numérica de 16 u 8 bits, lo que significa que cada parámetro requiere dos bytes o uno de memoria. Xiaomi comprime a una precisión de 4 bits las capas de expertos, que constituyen la mayoría de los parámetros del modelo de un billón. Esto reduce el espacio de memoria y la presión sobre el ancho de banda, lo que permite que los datos circulen más rápido por el sistema. El riesgo de la cuantización es que se pierda calidad, ya que una menor precisión puede perjudicar la capacidad de razonamiento del modelo. Xiaomi lo evita con una intervención selectiva: solo comprime las capas de expertos, mientras que el resto del modelo mantiene su precisión máxima. La empresa describe la pérdida de calidad resultante como casi nula.
La segunda técnica es la decodificación especulativa DFlash. La decodificación especulativa tradicional utiliza un modelo preliminar más pequeño para adivinar rápidamente los siguientes tokens y luego hace que el modelo grande verifique esas predicciones en paralelo. DFlash elimina por completo el paso secuencial de predicción. En su lugar, completa de una sola pasada hacia adelante un bloque entero de posiciones enmascaradas. En tareas de programación, el modelo grande acepta un promedio de 6,3 de los 8 tokens propuestos en cada ronda de verificación. Esto significa que se avanzan seis tokens en un paso, en vez de uno, lo que acelera enormemente la generación.
El tercer componente es el propio TileRT, el motor de inferencia que mantiene toda la cadena de procesamiento continuamente en la GPU. Los sistemas de servicio estándar suelen ejecutar los operadores uno por uno, lo que crea pequeñas pausas. TileRT elimina la sobrecarga de iniciar cada operador por separado y mantiene el flujo de datos sin interrupciones. Al combinarse con los pesos comprimidos del modelo y la estrategia avanzada de decodificación, el motor mantiene niveles de rendimiento que antes eran inalcanzables con hardware estándar.
Xiaomi denomina a esta combinación codesarrollo extremo entre modelo y sistema, una descripción acertada. Cada capa de optimización refuerza las demás y crea un resultado superior al que podría ofrecer por separado cualquiera de las técnicas.
Por qué la velocidad abre la puerta a aplicaciones completamente nuevas
Las cifras de rendimiento no significan nada si no hacen posible algo nuevo. A 1.000 tokens por segundo, MiMo-V2.5-Pro-UltraSpeed abre posibilidades que siguen fuera del alcance de los sistemas más lentos.
Piense en cómo utilizan actualmente los desarrolladores los modelos de lenguaje grandes para tareas complejas. Ante un problema difícil de programación, el usuario suele esperar una respuesta y confiar en que sea correcta. Con UltraSpeed, puede ejecutar en paralelo decenas de líneas de razonamiento durante el mismo intervalo de tiempo y verificarlas y corregirlas automáticamente en segundo plano. El modelo puede explorar varias soluciones al mismo tiempo, en lugar de optar por una sola cadena de razonamiento. Esta capacidad transforma fundamentalmente la IA: deja de ser un asistente secuencial y se convierte en un solucionador de problemas en paralelo.
Las industrias sujetas a estrictos límites de latencia pueden beneficiarse de inmediato. Los sistemas de detección de fraude deben evaluar transacciones en milisegundos. La generación de señales de inversión en tiempo real no admite demoras de varios segundos. Los ciclos de agentes autónomos, en los que los sistemas de IA observan, deciden y actúan rápidamente, requieren velocidades que los chatbots para consumidores no pueden ofrecer. A 68 tokens por segundo, estas aplicaciones se enfrentan a cuellos de botella frustrantes. A 1.000 tokens por segundo, son viables con la infraestructura estándar en la nube.
Incluso en las tareas cotidianas de programación, la velocidad cambia la experiencia. Antes, los desarrolladores se quedaban mirando la pantalla mientras esperaban a que terminara la inferencia. Con una velocidad de salida cercana o superior a los 1.000 tokens por segundo, la demora prácticamente desaparece. La interacción pasa de pedir y esperar a colaborar de verdad en tiempo real con un socio de IA. Las aplicaciones sanitarias que requieren un análisis rápido de los datos de los pacientes y las plataformas de inversión que procesan información de mercado en directo también obtienen un beneficio práctico inmediato de esta capacidad de respuesta.
Acceso, precios y publicación de código abierto
Xiaomi no mantiene esta tecnología bajo llave. La empresa ha puesto en marcha una prueba limitada de la API que estará disponible del 9 al 23 de junio de 2026. El acceso requiere presentar una solicitud y no está garantizado. Se dará prioridad a usuarios empresariales y desarrolladores profesionales con necesidades comerciales concretas. Debido a la disponibilidad limitada de recursos de inferencia de alta velocidad, cada cuenta puede incorporarse a la cola hasta diez veces al día, y cada sesión tiene un límite de treinta minutos. Las sesiones inactivas durante más de cinco minutos se cerrarán automáticamente.
El precio refleja el carácter prémium de la velocidad. UltraSpeed cuesta tres veces más que la tarifa estándar de MiMo-V2.5-Pro, pero genera texto aproximadamente diez veces más rápido. Como referencia, el MiMo-V2.5-Pro estándar ya es mucho más barato que Claude Opus: cobra unos 0,43 dólares por cada millón de tokens de entrada y 0,87 dólares por cada millón de tokens de salida, frente a los 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida de Opus. Incluso con una tarifa tres veces mayor, la oferta acelerada de Xiaomi sigue siendo mucho más barata que muchos otros modelos de vanguardia.
Para los desarrolladores que prefieren probar la tecnología directamente, Xiaomi ha publicado en Hugging Face y como código abierto el punto de control MiMo-V2.5-Pro-FP4-DFlash subyacente. TileRT también ha publicado módulos seleccionados en GitHub. Esta medida invita a la comunidad investigadora internacional a verificar las cifras, experimentar con la arquitectura y, posiblemente, adaptar las técnicas a otros modelos. La verificación independiente por parte de terceros aún no se ha difundido ampliamente, por lo que las pruebas de la comunidad con estas publicaciones abiertas serán la verdadera prueba durante las próximas semanas.
El discreto ascenso de Xiaomi como potencia de la IA
Para la mayoría de los consumidores, Xiaomi sigue siendo la marca que vende aparatos electrónicos asequibles. La empresa ha vendido millones de teléfonos inteligentes, patinetes eléctricos y purificadores de aire en los mercados internacionales. Esa imagen de marca orientada al consumidor ha ocultado una división de inteligencia artificial en constante crecimiento, a la que la mayor parte de la industria no prestó atención hasta ahora.
MiMo-V2.5-Pro ya igualaba a Claude Opus en la mayoría de las pruebas de programación cuando se lanzó en abril. UltraSpeed no presenta un modelo nuevo ni simplificado: acelera exactamente la misma inteligencia de vanguardia que ya competía al máximo nivel. La marca de teléfonos ha creado, en la práctica, una capacidad de IA que rivaliza con la de laboratorios especializados y mantiene precios hasta diez veces más bajos.
Si las afirmaciones sobre la velocidad resisten el examen independiente, Xiaomi habrá logrado algo extraordinario sin la inversión de cientos de millones de dólares en silicio personalizado que necesitaron empresas como Cerebras y Groq. Habrá demostrado que la optimización de software en hardware comercial puede ofrecer un rendimiento líder en su categoría. Ese resultado cambiaría las ideas establecidas sobre el origen de las capacidades de IA y sobre qué actores pueden competir en la vanguardia. Un gigante de la electrónica de consumo de Pekín acaba de incorporarse a la élite de los innovadores en infraestructura de IA, y lo ha hecho con GPU estándar en lugar de silicio personalizado.
En síntesis
- MiMo-V2.5-Pro-UltraSpeed, de Xiaomi, genera más de 1.000 tokens por segundo en un modelo de un billón de parámetros, utilizando solo ocho GPU comerciales estándar y sin necesidad de silicio personalizado.
- Es aproximadamente quince veces más rápido que GPT-5.5 y Claude Opus. Lo consigue mediante la cuantización FP4, la decodificación especulativa DFlash y el motor de inferencia TileRT.
- La prueba limitada de la API estará disponible del 9 al 23 de junio de 2026. Cuesta tres veces más que la tarifa estándar de MiMo y ofrece una velocidad de generación aproximadamente diez veces mayor. Se dará prioridad a empresas y desarrolladores profesionales.
- Xiaomi ha publicado el punto de control FP4-DFlash como código abierto en Hugging Face, lo que permite a la comunidad verificar y adaptar estas técnicas.
- Si se verifica de forma independiente, el avance indicaría que la optimización de software en hardware estándar en la nube puede superar las soluciones costosas basadas en chips personalizados de empresas especializadas en hardware de IA.