Un millón de intercambios convierte palabras inventadas en significados compartidos
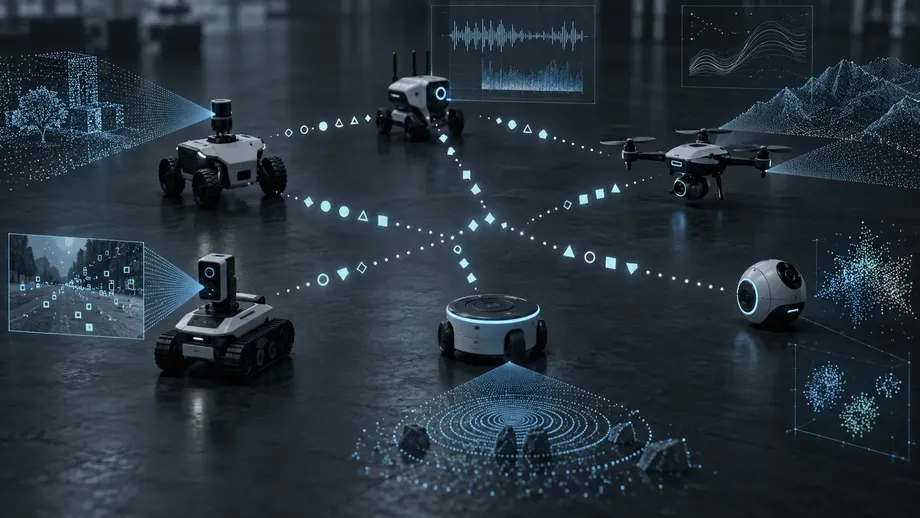
Diez agentes de inteligencia artificial, que comenzaron sin vocabulario, aprendieron a identificar objetos entre sí con una tasa de éxito de hasta el 99,76% después de un millón de interacciones, según experimentos de investigadores de la Vrije Universiteit Brussel (VUB) y la Universidad de Namur, en Bélgica. Las palabras y sus significados surgieron de intercambios repetidos, no de un diccionario creado por personas.
Contenido
- Un millón de intercambios convierte palabras inventadas en significados compartidos
- Cómo una palabra se vuelve útil
- Qué almacenan los agentes como significado
- ¿Qué eficacia tuvieron los vocabularios compartidos?
- Los sensores diferentes también pueden permitir un acuerdo
- Un vocabulario que cambia cuando desaparecen datos de entrada
- Los grupos más grandes necesitan más intercambios
- Las personas pueden examinar a qué se refiere una palabra
- Publicación, colaboración y posibles aplicaciones
- Puntos clave
Los investigadores probaron su método con 37 conjuntos de datos públicos, desde mediciones químicas del vino y datos de exoplanetas de la NASA hasta fotografías de aves y rostros humanos. En siete conjuntos de datos destacados, la tasa de éxito en las interacciones de prueba osciló entre el 95,77% y el 99,76%.
El principal logro fue alcanzar un acuerdo sobre cómo referirse a las cosas. Cada agente conservó sus propias asociaciones entre las palabras inventadas y las propiedades observadas. Mediante la retroalimentación, esas asociaciones individuales llegaron a ser lo bastante compatibles para que el grupo pudiera comunicarse, incluso cuando sus integrantes percibían el entorno de manera diferente.
El artículo de investigación, titulado Comunicación emergente en mundos continuos: autoorganización de vocabularios con fundamento conceptual a gran escala, describe experimentos de simulación por computadora. Los agentes trabajaron con representaciones numéricas de objetos e imágenes. Los investigadores señalan que este enfoque podría aplicarse a robots, vehículos autónomos y sensores industriales.
Cómo una palabra se vuelve útil
En cada intercambio participan dos agentes. Uno asume el papel de emisor y el otro, de receptor, y los roles vuelven a asignarse a medida que continúan las interacciones. Ambos observan una escena con varias entidades, pero solo al emisor se le indica cuál es la entidad objetivo.
El emisor debe elegir una palabra que ayude al receptor a seleccionar ese objetivo. Si su vocabulario no incluye una palabra adecuada, inventa una. El artículo utiliza cadenas arbitrarias de tres sílabas, como «demoxu», de modo que la etiqueta no tiene un significado propio.
El receptor compara la palabra con los conceptos que tiene almacenados y elige una entidad. Ambos agentes reciben información sobre si la elección fue correcta. Tras un fallo, se revela el objetivo al receptor, que así obtiene información para revisar su interpretación.
Los investigadores proporcionaron los procedimientos para inventar palabras, representar conceptos y aprender de los resultados. El vocabulario concreto y las categorías asociadas surgieron durante la interacción. Los intercambios exitosos refuerzan las asociaciones útiles, mientras que la experiencia posterior ajusta los conceptos asociados a las palabras.
Katrien Beuls, profesora de la Universidad de Namur y coautora del estudio, describió en el comunicado de la universidad cómo los intercambios locales generan acuerdos en toda una población:
«Lo fascinante es que no hay una computadora central que imponga las reglas. Cada vez, permitimos que dos agentes se comuniquen entre sí a nivel local. Es únicamente mediante estas interacciones y actualizaciones individuales que surge espontáneamente una convención global en toda la población».
Qué almacenan los agentes como significado
Para un agente, cada entidad se presenta como un vector de características: una lista de valores que describe sus propiedades. Por ejemplo, una muestra de vino puede representarse mediante mediciones químicas. Una imagen puede representarse con características numéricas extraídas por un sistema de visión.
Una palabra se vincula a un prototipo conceptual: una descripción matemática de los tipos de observaciones a los que se aplica. El prototipo registra valores típicos, cuánto varían esos valores y qué características son más importantes. Esto permite al agente evaluar hasta qué punto una entidad nueva coincide con una palabra conocida.
El contexto también importa. El emisor busca una palabra cuyo concepto se ajuste al objetivo mejor que a las demás entidades de la escena. Por tanto, una palabra útil permite distinguir algo de las alternativas inmediatas, en lugar de limitarse a asignar una etiqueta permanente a cada objeto.
Los agentes mantienen estas representaciones de forma privada. No tienen acceso a los ajustes internos de los demás ni a una base de conocimientos central. La comunicación compartida se desarrolla porque sus palabras orientan elecciones compatibles, mientras que sus representaciones individuales siguen vinculadas a sus propias observaciones.
Para los conjuntos de datos de imágenes, los investigadores utilizaron características de 384 dimensiones de DINOv2, un codificador de visión ya existente. Un codificador de visión convierte una imagen en una descripción numérica que otros programas pueden procesar. El aprendizaje del vocabulario se realizó a partir de esas descripciones.
¿Qué eficacia tuvieron los vocabularios compartidos?
En los experimentos estándar, se entrenó a grupos de 10 agentes durante un millón de interacciones. Después, los investigadores evaluaron la comunicación en 100.000 interacciones de prueba, incluidas algunas con entidades que no se habían utilizado en el entrenamiento, y calcularon el promedio de 10 ejecuciones independientes.
Los siete resultados destacados muestran tanto la eficacia del método como las diferencias entre tareas:
- CLEVR, un conjunto de datos sobre atributos visuales de objetos: 99,76% de éxito comunicativo.
- Datos de análisis del vino: 99,76%.
- Datos de exoplanetas: 99,67%.
- Datos de hongos: 98,10%.
- Imágenes del conjunto de datos MS COCO: 95,77%.
- Imágenes de rostros de CelebA: 96,66%.
- Imágenes de aves: 95,88%.
Estos porcentajes miden la frecuencia con que el receptor seleccionó la entidad prevista. En las tareas de vino y CLEVR, el 99,76% equivale a unos 24 intercambios fallidos por cada 10.000 interacciones de prueba. En MS COCO, el 95,77% equivale a unos 423 por cada 10.000.
La diferencia entre esos resultados es de 3,99 puntos porcentuales. La comunicación siguió siendo muy eficaz en las tareas destacadas, pero los conjuntos de datos de imágenes naturales produjeron más errores que las tareas sobre vino y exoplanetas.
El equipo también midió el tamaño del vocabulario y el grado de acuerdo sobre las convenciones, que indica hasta qué punto los agentes usan las palabras de manera coherente. Estas medidas evalúan aspectos distintos del proceso: una población necesita tanto un conjunto viable de etiquetas como suficiente acuerdo sobre su uso para identificar objetivos de forma fiable.
Los sensores diferentes también pueden permitir un acuerdo
Las máquinas rara vez observan el mundo exactamente de la misma manera. Los sensores pueden tener distintos ajustes de calibración, las mediciones pueden contener ruido y un dispositivo puede captar propiedades que otro no detecta. El estudio probó variaciones de estas condiciones.
Paul Van Eecke, profesor de inteligencia artificial en la VUB y coautor del estudio, explicó la motivación con el ejemplo de varias personas que identifican un automóvil rojo. Pueden entender la misma descripción aunque sus ojos registren valores de color ligeramente distintos. La palabra compartida se sitúa por encima de esas mediciones individuales.
En los experimentos, esa idea se aplicó a agentes artificiales mediante cambios en sus observaciones. Se incluyeron desplazamientos numéricos similares a diferencias de calibración, ruido en los valores observados y poblaciones cuyos integrantes disponían de diferentes conjuntos de características.
En los experimentos con CLEVR bajo un nivel elevado de ruido, el éxito comunicativo fue del 87,67%. En una condición con mayores diferencias entre los sensores disponibles, fue del 83,47%. El método mantuvo una capacidad considerable de coordinación en estas condiciones, aunque con menor precisión que en el experimento estándar con CLEVR.
El artículo describe como heteromórficas a las poblaciones con estructuras perceptivas diferentes. En términos sencillos, sus integrantes reciben tipos o cantidades de información distintos. Su tarea es desarrollar referencias compatibles a pesar de esas diferencias, utilizando las observaciones a las que cada uno tiene acceso.
Un vocabulario que cambia cuando desaparecen datos de entrada
Los investigadores también probaron la pérdida repentina de información durante el aprendizaje. En un experimento, se eliminó a mitad del proceso la mitad de las entradas que representaban lecturas de sensores. Tras ese cambio, el éxito comunicativo llegó al 93,82%.
La interacción continua permite que los agentes revisen sus conceptos cuando cambian las condiciones. Una palabra asociada a varias características puede adquirir otra utilidad cuando algunas desaparecen y las observaciones restantes cobran más importancia.
El artículo también informa sobre la adaptación a cambios del entorno. Esto convierte el aprendizaje continuo en un elemento central del enfoque: la población construye una convención mediante el uso y sigue ajustándola a medida que cambian sus observaciones.
En un futuro sistema de máquinas, esa capacidad podría ser importante si los equipos se deterioran o cambian las condiciones de funcionamiento. El resultado experimental inmediato se refiere a la adaptación del vocabulario de los agentes en las tareas simuladas.
Los grupos más grandes necesitan más intercambios
El estudio examinó poblaciones de 2, 10, 25, 50 y 100 agentes. Ampliar una población modifica el alcance que debe tener cada palabra útil, ya que los intercambios siguen produciéndose entre pares de individuos.
En los experimentos con CLEVR y 100 agentes, el éxito comunicativo llegó al 92,69% después de un millón de interacciones. Al ampliar el entrenamiento a 10 millones de interacciones, aumentó al 99,16%, es decir, 6,47 puntos porcentuales.
El volumen de interacciones ayuda a explicar la magnitud del desafío. Si la participación se distribuye de manera uniforme, un millón de intercambios con dos agentes cada uno supone un promedio de 200.000 participaciones por agente en un grupo de 10. En un grupo de 100, ese mismo número de intercambios supone un promedio de 20.000 participaciones por agente.
Con 10 millones de intercambios, el promedio vuelve a ser de 200.000 participaciones por integrante en una población de 100. Los encuentros individuales se seleccionan al azar, pero esta comparación muestra por qué un grupo más grande puede necesitar un volumen de aprendizaje mucho mayor para difundir sus convenciones.
Las personas pueden examinar a qué se refiere una palabra
Los investigadores señalan que la interpretabilidad es una ventaja de su diseño. Cada palabra remite a un prototipo cuyos valores y ponderaciones de características se pueden examinar. Los investigadores pueden rastrear qué observaciones ayudaron a formar un concepto y cómo cambia su representación con el uso.
En un conjunto de datos con mediciones químicas identificadas por nombre, el examen puede vincular una palabra a intervalos concretos de esas mediciones. En el caso de las imágenes, el concepto se vincula a las características generadas por el codificador de visión, por lo que explicar su significado también requiere comprender esas representaciones numéricas de las imágenes.
Jérôme Botoko Ekila, investigador doctoral del Laboratorio de Inteligencia Artificial de la VUB y coautor del estudio, explicó el propósito de permitir que los agentes construyan conceptos a partir de sus propias percepciones:
«Construyen conceptos eficaces que corresponden exactamente a lo que perciben a través de sus sensores, aunque los datos resulten incomprensibles para las personas».
La supervisión humana implicaría examinar esas asociaciones a medida que se desarrollan. Una comprobación útil consiste en verificar si dos agentes que utilizan la misma palabra siguen seleccionando la entidad prevista después de que cambien sus entradas o el entorno. El mecanismo de retroalimentación del estudio hace que esa relación sea fundamental para el aprendizaje.
Publicación, colaboración y posibles aplicaciones
El trabajo reúne a Jérôme Botoko Ekila, Lara Verheyen, Jens Nevens y Paul Van Eecke, de la VUB, y a Katrien Beuls, de la Universidad de Namur. La financiación provino del Fondo de Investigación de Flandes (FWO) y del Fondo Nacional de Investigación de Bélgica (FNRS), a través del proyecto WEAVE.
El registro de publicaciones de la VUB identifica la revista como Transactions of the Association for Computational Linguistics, volumen 14, páginas 2234–2257, con el DOI 10.1162/TACL.a.799. Indica que la publicación tuvo lugar en agosto de 2026.
La publicación y el anuncio siguieron esta secuencia:
- Abril de 2026: se presentó el artículo.
- Mayo de 2026: se revisó el artículo.
- Agosto de 2026: el registro de publicaciones de la universidad indica que se publicó en la revista.
- 14 de octubre de 2026: la universidad presentó los resultados en un comunicado.
Los investigadores señalan que los vehículos autónomos, los robots y los sensores industriales podrían utilizar sistemas de comunicación adaptados a las percepciones de las máquinas. El lidar mide distancias mediante luz, el sonar utiliza sonido, los sensores infrarrojos detectan radiación asociada a la temperatura y los instrumentos químicos miden sustancias. Un vocabulario compartido podría ayudar a las máquinas a referirse a patrones útiles presentes en esas distintas entradas.
El siguiente paso práctico sería probar cómo funcionan estas convenciones con equipos físicos, entornos cambiantes y exigencias operativas. No se indicó ningún calendario para su implementación. Por ahora, el resultado es un método probado para crear referencias compartidas a partir de datos diversos, con un rendimiento medible ante el ruido, las diferencias perceptivas y la pérdida de entradas.
Puntos clave
- Investigadores de la VUB y de la Universidad de Namur probaron la formación de vocabularios con 37 conjuntos de datos públicos.
- Grupos de 10 agentes se entrenaron mediante un millón de interacciones y después realizaron 100.000 interacciones de prueba.
- En siete conjuntos de datos destacados, el éxito osciló entre el 95,77% y el 99,76%.
- Los investigadores proporcionaron los procedimientos de aprendizaje; los agentes desarrollaron las palabras concretas y los conceptos asociados mediante retroalimentación.
- Los experimentos probaron la adaptación a observaciones ruidosas, estructuras perceptivas diferentes y entradas ausentes.
- Una población de 100 agentes alcanzó un éxito del 99,16% en CLEVR después de 10 millones de interacciones.
- El estudio utilizó simulaciones por computadora. Se proponen aplicaciones en robots, vehículos y sensores industriales.