Una nueva visión para el control de juegos
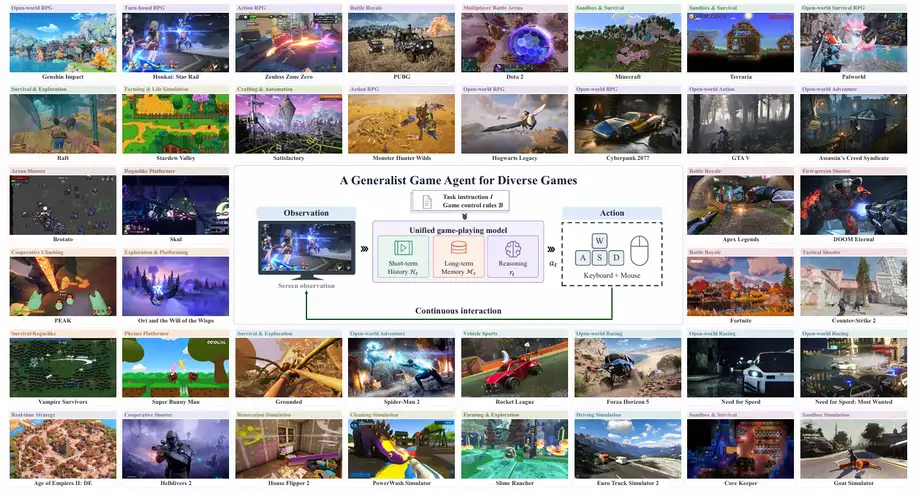
Los investigadores de miHoYo, que trabajan a través del equipo de investigación y desarrollo de inteligencia artificial de Honkai y en colaboración con múltiples instituciones académicas, han presentado un modelo fundacional de visión-lenguaje-acción denominado Gamer. El proyecto se aleja de los sistemas tradicionales que dependen de interfaces de programación de aplicaciones internas de los juegos o de estados de memoria modificados. En su lugar, el marco de trabajo procesa la entrada visual sin procesar de las pantallas de los juegos y traduce esas observaciones directamente en comandos estándar de teclado y ratón. El equipo de desarrollo detalló la arquitectura subyacente en un preimpreso titulado Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent, publicado en arXiv con un historial de envío que comienza el 13 de noviembre de 2026 y una revisión final el 18 de noviembre de 2026. Las instituciones de investigación participantes incluyen la Universidad Nacional de Singapur, la Universidad Tsinghua, la Universidad de la Academia China de Ciencias, la Universidad de Ciencia y Tecnología de China y la Universidad de Xi'an Jiaotong. La dirección del proyecto cuenta con figuras destacadas como David Jiang, productor de varios títulos principales de la franquicia Honkai, y Zheng Yinhe, jefe del equipo técnico de inteligencia artificial de personajes no jugables y de jugabilidad de la serie Honkai.
Contenido
A diferencia del software convencional que requiere acceso privilegiado al código de los juegos, Gamer interactúa con los entornos digitales de manera muy similar a la de un jugador humano. El modelo captura fotogramas de pantalla a una frecuencia de cinco hercios y utiliza estas señales visuales junto con las instrucciones de la tarea y el historial de observaciones para determinar las acciones apropiadas. Estas decisiones se manifiestan como una serie de estados de teclado de bajo nivel y movimientos de ratón ejecutados a un ritmo de control de treinta hercios. Al tratar la interacción del usuario como un formato compartido que abarca las interfaces gráficas convencionales y los mundos simulados tridimensionales complejos, el marco de trabajo proporciona un enfoque unificado para la navegación y la ejecución digitales.
Canales de entrenamiento y aprendizaje en múltiples fases
Construir un agente autónomo capaz de mantener una jugabilidad de largo alcance requiere ir más allá del ajuste estándar de instrucciones multimodales. El equipo de investigación implementó un flujo de entrenamiento integral dividido en tres fases distintas. La fase inicial consiste en un preentrenamiento continuado con un gran conjunto de datos compuesto por decenas de miles de horas de trayectorias de interacción de teclado y ratón a nivel de dispositivo. Estos registros de interacción abarcan juegos simulados y entornos incorporados, lo que permite al modelo aprender la dinámica de los entornos y las correlaciones visomotoras en diversos entornos digitales. Según la documentación del proyecto, los datos de entrenamiento incorporan trayectorias de interacción de fuentes como VPT, D2E, OpenP2P y grabaciones de Honkai: Star Rail.
Después del preentrenamiento continuado, el modelo se somete a un ajuste de instrucciones con razonamiento disperso. En esta fase, el marco de trabajo aprende a equilibrar la ejecución motora inmediata con la planificación deliberada. En lugar de generar texto explicativo continuo para cada fotograma, el modelo ejecuta directamente los movimientos rutinarios y reserva bloques de razonamiento explícito para puntos clave de decisión, como secuencias de resolución de acertijos o decisiones narrativas. La fase final de entrenamiento introduce un método de aprendizaje de refuerzo en línea denominado Optimización de Política Relativa de Grupo con Conciencia Temporal (Temporal-Aware Group Relative Policy Optimization). Esta técnica aborda los desafíos de las ventanas de contexto finitas, los errores de despliegue acumulados durante secuencias de tareas largas y las recompensas escasas, vinculando segmentos de trayectoria mediante resúmenes de memoria persistentes.
Gestión de la memoria y ejecución de largo alcance
Ejecutar tareas que se extienden durante horas de juego plantea obstáculos significativos relacionados con la retención de memoria y los límites de contexto. Cuando un agente explora mundos virtuales extensos, las interacciones tempranas se desvanecen rápidamente de la ventana de contexto activa, lo que provoca errores de navegación u objetivos olvidados. Para preservar el progreso de la tarea sin sobrecargar el sistema con historiales de conversación que crecen indefinidamente, los investigadores incorporaron un mecanismo de memoria persistente. A medida que avanzan las tareas y las interacciones más antiguas salen del contexto activo, el modelo genera resúmenes compactos que registran hitos completados, intentos fallidos, ubicaciones importantes y planes posteriores.
La eficacia de este enfoque de entrenamiento por etapas y gestión de la memoria se evaluó mediante pruebas rigurosas en escenarios específicos de juego de rol. En misiones secundarias evaluadas de Honkai: Star Rail, las tasas de completado de hitos mostraron una mejora constante a lo largo de las etapas de entrenamiento. En la misión secundaria titulada «La oportunidad hace al ladrón (Parte I)», las tasas de completado de hitos pasaron del 34,4 % tras el preentrenamiento continuado al 72,2 % después del ajuste supervisado, y alcanzaron el 80,0 % con la aplicación del aprendizaje de refuerzo en línea. De manera similar, en la misión secundaria «Ferocidad bestial», las tasas de completado progresaron del 47,9 % al 69,1 % y, en última instancia, alcanzaron el 83,6 % tras la optimización con aprendizaje de refuerzo. En un conjunto evaluado de cuarenta tareas de minijuegos no conocidas, una versión denominada Gamer-RL alcanzó una tasa de éxito media del 49,7 %.
Inferencia en tiempo real y arquitectura de streaming
Mantener un alto rendimiento durante la interacción en tiempo real exige que la latencia de inferencia se mantenga muy por debajo de los umbrales de tolerancia del software interactivo. Para evitar retrasos que harían que un agente perdiera eventos dinámicos en entornos de ritmo rápido, el equipo de desarrollo creó un sistema de servicio de nube y borde denominado Streaming-vLLM. Este motor de inferencia combina la reutilización persistente de contexto, la decodificación especulativa verificada y el envío temprano de acciones para procesar de manera eficiente los despliegues paralelos. La reutilización persistente de contexto evita cálculos redundantes de los estados históricos de la pantalla al conservar las cachés de clave-valor entre fotogramas, mientras que el envío temprano de acciones transmite el primer grupo válido de comandos de teclado al cliente del juego antes de que se termine de generar los tokens siguientes.
Las pruebas de rendimiento detalladas en el repositorio del proyecto ilustran el impacto de estas optimizaciones. Al funcionar en un entorno equipado con hardware NVIDIA H200 y utilizar una configuración de modelo basada en Qwen3.5-35B-A3B con paralelismo tensorial configurado en cuatro, la configuración de referencia registró una latencia de solicitud de extremo a extremo de 1.306,00 milisegundos. Tras aplicar las optimizaciones de Streaming-vLLM, esa latencia de solicitud bajó a 65,12 milisegundos. Esta reducción en el tiempo de ejecución permite al sistema admitir evaluaciones en línea simultáneas y mantener bucles de control receptivos durante secuencias complejas de navegación espacial y combate.
Alcance de la investigación y límites prácticos
La publicación de este marco de investigación ha generado un amplio debate sobre sus capacidades potenciales y sus aplicaciones previstas. La documentación del proyecto y las declaraciones públicas del equipo de investigación enfatizan que Gamer es un proyecto de exploración académica diseñado para investigar el comportamiento de agentes polivalentes en entornos interactivos, y no una herramienta comercial autorizada para automatizar cuentas de jugadores ni para generar ventajas competitivas. Para atender a consideraciones de seguridad de los datos, el equipo retuvo los datos de entrenamiento específicos y los pesos del modelo asociados a títulos propietarios, dejando disponibles públicamente solo los archivos de preentrenamiento fundamentales y la documentación del sistema a través de recursos como el repositorio de Gamer en GitHub.
Las posibles aplicaciones prácticas esbozadas por los desarrolladores se centran principalmente en la utilidad industrial y de desarrollo, y no en la automatización para el consumidor. Los flujos de pruebas automatizadas podrían aprovechar tales modelos para realizar pruebas de estrés en rutas narrativas ramificadas y mundos virtuales extensos, identificando defectos de implementación con más rapidez que los métodos tradicionales de verificación manual. Además, los principios subyacentes ofrecen conocimientos sobre la asistencia de accesibilidad y la investigación en interacción persona-computadora, allanando el camino para agentes capaces de traducir modalidades de entrada diversas en acciones digitales precisas.
Lo esencial
- El marco de investigación fue desarrollado por el equipo de investigación y desarrollo de inteligencia artificial de Honkai de miHoYo en colaboración con instituciones académicas como la Universidad Nacional de Singapur y la Universidad Tsinghua.
- Los hallazgos detallados y las descripciones arquitectónicas están documentados en el preimpreso Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent.
- El sistema captura observaciones de pantalla sin procesar a cinco hercios y emite comandos nativos de teclado y ratón sin requerir interfaces de programación de aplicaciones internas ni ganchos de memoria.
- Los procedimientos de entrenamiento incorporan preentrenamiento continuado con decenas de miles de horas de trayectorias de interacción, ajuste de instrucciones con razonamiento disperso y Optimización de Política Relativa de Grupo con Conciencia Temporal.
- El motor de inferencia personalizado, Streaming-vLLM, redujo la latencia de solicitud de 1.306,00 milisegundos a 65,12 milisegundos en pruebas con hardware NVIDIA H200.
- El equipo de investigación sostiene que el proyecto constituye un estudio académico orientado a aplicaciones como las pruebas automatizadas y la investigación en accesibilidad, y no una herramienta comercial para la automatización de la jugabilidad.