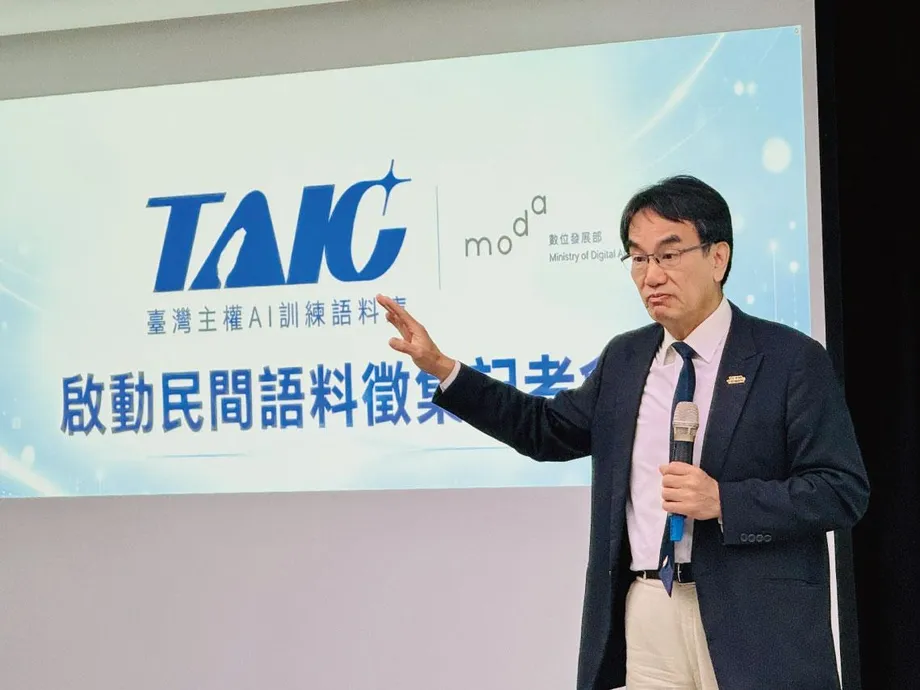
111 aportes privados revelan una brecha en las ambiciones de IA de Taiwán
La colección gubernamental de datos para entrenar IA de Taiwán ha reunido 7.161 entradas, pero solo 111 proceden de colaboradores privados. Esto equivale a cerca del 1,6 % del total, una proporción pequeña para un proyecto destinado a ayudar a la inteligencia artificial a comprender el idioma, la cultura y la vida cotidiana de Taiwán.
Contenido
- 111 aportes privados revelan una brecha en las ambiciones de IA de Taiwán
- Qué contiene la colección gubernamental
- Por qué importa el idioma local
- Una denuncia penal cambió los cálculos
- Cómo intervienen los derechos de autor en el entrenamiento de IA
- Permiso voluntario, no transferencia de la titularidad
- La cooperación remunerada ya tiene un pequeño precedente
- Las excepciones legales y las licencias colectivas son opciones en debate
- TAIDE muestra por qué importan tanto el acceso como los recursos
- Puntos clave
El Ministerio de Asuntos Digitales puso en marcha el Corpus Soberano de Entrenamiento de IA de Taiwán el 24 de diciembre de 2025, con la participación de más de 200 organismos gubernamentales que aportaron más de 2.000 conjuntos de datos con 600 millones de tokens. Los tokens son pequeñas unidades de texto que procesan los sistemas de IA; a veces son un carácter y otras, parte de una palabra.
La participación gubernamental ha contribuido a alcanzar una escala considerable. Incorporar a editoriales, autores, plataformas educativas y organizaciones de noticias plantea un problema más complejo: los desarrolladores necesitan permiso para copiar textos valiosos con fines de entrenamiento, mientras que los titulares de los contenidos quieren recibir un pago y controlar cómo se utilizan sus obras.
En una audiencia legislativa celebrada el 14 de octubre de 2026, la ministra de Asuntos Digitales, Lin Yi-jing, dijo que la participación privada era voluntaria y que el Gobierno quería que las principales empresas de IA, especialmente las estadounidenses, pagaran por el contenido utilizado para el entrenamiento. El contenido periodístico queda fuera del programa actual de recopilación privada.
Lo que está en juego va más allá del tamaño de una base de datos. Un modelo entrenado con textos taiwaneses puede aprender vocabulario local, explicar tradiciones culturales y responder preguntas teniendo en cuenta las instituciones de Taiwán. Sin embargo, los autores y las organizaciones que producen ese material también dependen de su valor comercial. Taiwán intenta ampliar el acceso a sus obras mientras decide quién debe pagar, qué abarca el permiso y qué aspectos de las normas de derechos de autor necesitan aclararse.
Qué contiene la colección gubernamental
El anuncio del lanzamiento de diciembre del ministerio describe una colección sobre idioma, cultura, educación, biología y geografía. Se basa en más de diez años de datos abiertos del Gobierno y permite buscar y descargar materiales.
El Ministerio de Cultura aportó conjuntos de datos sobre arte público y bienes culturales. El Ministerio de Educación contribuyó con datos de diccionarios de taiwanés, hakka y mandarín. Estos recursos ofrecen a los desarrolladores material sobre significados y usos locales, además de información sobre lugares, objetos y tradiciones.
La descripción del programa del corpus del ministerio también menciona al Consejo de los Pueblos Indígenas y al Consejo de Asuntos Hakka entre los organismos participantes. Entre los temas previstos figuran la historia, el patrimonio cultural, el turismo y la cultura local. El ministerio afirma que los textos útiles para el entrenamiento deben ser coherentes, completos y fluidos.
Las cifras de septiembre de 2026 presentadas ante los legisladores situaban la colección en más de 5.000 conjuntos de datos y más de 2.400 millones de tokens. En comparación con los 600 millones de tokens anunciados al lanzamiento, esto representa más de cuatro veces esa cantidad de texto medida en tokens. Las 7.161 entradas y los 111 aportes privados ofrecen otra imagen de su composición.
Por qué importa el idioma local
Wu Che-yu, artista de nuevos medios que fundó el proyecto comunitario de conocimiento Taiwan.md, sostiene que los textos en chino tradicional ocupan un espacio demasiado reducido en el entrenamiento general de IA. Estima que representan menos del 1 % del material de entrenamiento en chino, una cifra que cita al explicar su proyecto.
La preocupación de Wu va más allá de convertir caracteres simplificados en tradicionales. Taiwán y China usan palabras distintas para algunas cosas cotidianas, y una misma expresión puede tener significados diferentes. El conocimiento local también abarca las instituciones, la historia y la gastronomía, incluidos platos que reciben menos atención internacional que el té de burbujas o los dumplings de sopa.
Taiwan.md utiliza herramientas de IA para recopilar información de internet y editar artículos sobre la naturaleza, la sociedad y la historia de Taiwán. Sus 1.123 artículos se basan en trabajos académicos, blogs e información gubernamental de acceso público. Wu quiere que modelos de uso general como ChatGPT, Gemini y Claude encuentren más textos que reflejen la experiencia taiwanesa.
El Gobierno describe su ambición relacionada como IA soberana: desarrollar recursos y capacidades de IA que Taiwán pueda adaptar a sus propias necesidades. Su corpus aporta material para el entrenamiento; proyectos como Taiwan.md buscan facilitar a los desarrolladores de IA la búsqueda de conocimiento local.
Una denuncia penal cambió los cálculos
En julio de 2025, un estudiante de doctorado de la Universidad Nacional de Taiwán afrontó una denuncia penal por derechos de autor tras distribuir un corpus en chino tradicional con 140.000 artículos de la Agencia Central de Noticias que no estaban autorizados. El estudiante había recopilado material de un sitio web estadounidense que alojaba recursos abiertos y compartió la colección sin cobrar.
Las partes llegaron posteriormente a un acuerdo. El estudiante se disculpó, instó a los investigadores a comprobar la legalidad de sus fuentes de datos y retiró todo el corpus.
Wu afirma que el caso ha llevado a los desarrolladores independientes a actuar con más cautela. Su equipo de Taiwan.md descarta materiales cuando detecta un posible problema de derechos de autor, lo que ralentiza la ampliación de su colección. Para un proyecto pequeño, la posibilidad de afrontar un proceso penal añade un riesgo personal a la ya difícil tarea de comprobar los permisos.
Varias fechas ayudan a entender cómo evolucionó el asunto:
- Principios de 2023: El Consejo Nacional de Ciencia y Tecnología puso en marcha el proyecto del modelo lingüístico TAIDE con una financiación superior a 200 millones de dólares taiwaneses.
- Julio de 2025: El estudiante de doctorado afrontó una denuncia relacionada con el corpus que contenía artículos de noticias no autorizados.
- 24 de diciembre de 2025: El Ministerio de Asuntos Digitales anunció su corpus soberano de IA con 600 millones de tokens.
- Septiembre de 2026: Las cifras del ministerio mostraron más de 5.000 conjuntos de datos y más de 2.400 millones de tokens.
- 14 de octubre de 2026: La ministra Lin dijo a los legisladores que los aportes privados eran voluntarios y que los acuerdos de pago por contenidos eran un objetivo de la política gubernamental.
Cómo intervienen los derechos de autor en el entrenamiento de IA
Chen Chi-tung, abogado sénior del bufete Luguo, considera que la copia es una cuestión jurídica central. Por lo general, los desarrolladores necesitan reproducir los textos antes de utilizarlos para entrenar un modelo. La legislación sobre derechos de autor concede a los titulares el control de la reproducción, con excepciones como el uso legítimo.
El uso legítimo permite ciertos usos de obras protegidas sin autorización en circunstancias específicas. Chen afirma que las disposiciones vigentes en Taiwán no abordan expresamente el entrenamiento de IA, lo que deja a los desarrolladores sin saber si un tribunal aceptaría ese uso.
El entrenamiento y la generación de respuestas también son actividades distintas. Durante el entrenamiento, un sistema procesa ejemplos para aprender patrones. Durante la generación, produce texto para un usuario. Chen propone que la legislación aborde ambas etapas por separado, incluido el riesgo de que los resultados se parezcan mucho a obras protegidas.
La Oficina de Propiedad Intelectual, dependiente del Ministerio de Asuntos Económicos, afirma que sigue estudiando posibles ajustes legales. El Ministerio de Asuntos Digitales señala que esa oficina es responsable de la política sobre derechos de autor. Una investigación del Yuan de Control también instó a trabajar activamente en la adaptación del marco jurídico, después de que el Yuan Ejecutivo asignara esa tarea a la oficina.
Permiso voluntario, no transferencia de la titularidad
La ministra Lin dijo ante el Comité de Transporte de la Asamblea Legislativa que el programa de recopilación privada comienza con editoriales y plataformas de libros electrónicos. Describió cuatro tipos de materiales que se buscan:
- Libros cuyos derechos de autor hayan vencido.
- Descripciones de libros proporcionadas por las editoriales.
- Fragmentos seleccionados de libros para consulta previa.
- Obras que autores individuales autoricen voluntariamente.
Lin dijo que el ministerio solicitaba permiso para utilizar las obras en el entrenamiento de IA, mientras los autores conservaban la titularidad de los derechos de autor. Una licencia permite que otra parte realice determinadas actividades en las condiciones acordadas. Su alcance puede incluir aspectos como los usos permitidos y la duración.
Lin Chu-yin, legisladora del Partido Democrático Progresista, preguntó cómo se pagaría a los colaboradores, qué ocurriría si luego retiraban el permiso y cómo se protegerían sus intereses si el entrenamiento daba lugar a otros productos. Hung Yu-hsiang, legislador del Partido Popular de Taiwán, propuso un servicio que se ocupara de los controles de calidad, la autorización de derechos, la adquisición remunerada y la gestión de distintas categorías de licencias.
El ministerio ha publicado la Licencia del Corpus Soberano de Entrenamiento de IA de Taiwán, versión 1, y ha trabajado con la Oficina de Propiedad Intelectual en ejemplos para ayudar a los organismos a aplicarla. Las condiciones estándar buscan reducir las negociaciones repetidas y las disputas por derechos de autor. El ministerio también planea ofrecer incentivos para los aportes. Las tasas de pago, las condiciones para retirar el permiso y las normas aplicables a los productos resultantes aún no se han definido en las propuestas presentadas públicamente.
La cooperación remunerada ya tiene un pequeño precedente
Lee Po-feng, presidente de la Fundación de Cultura Abierta, afirma que es poco probable que pedir a las editoriales que aporten gratis material valioso consiga una participación suficiente. Señala un pequeño proyecto de entrenamiento que obtuvo la colaboración de medios y plataformas educativas mediante un intercambio negociado.
Las condiciones incluían un pago único por la licencia, un límite de dos años para el uso de los datos y acceso prioritario al modelo resultante para los proveedores de contenido participantes. El acuerdo ofreció a los colaboradores una compensación económica, un periodo de uso definido y algo útil a cambio.
Wang Rong-wen, presidente de la editorial Yuan-Liou, también sostiene que los desarrolladores gubernamentales y comerciales deberían presupuestar licencias de contenido. Considera que el temor a las denuncias penales limita tanto a los desarrolladores privados como a los funcionarios que intentan apoyar proyectos de IA.
Lin dijo a los legisladores que el objetivo final del Gobierno era que las principales empresas de IA pagaran por el acceso. Señaló que las disputas sobre derechos de autor relacionadas con nuevas tecnologías pueden durar de tres a cinco años, por lo que el ministerio comenzaba con materiales que generan menos controversias. Su estimación se refería a la probable duración de las disputas, no a un plazo para aprobar una ley o establecer un sistema de pagos.
Las excepciones legales y las licencias colectivas son opciones en debate
Chen propone incluir un capítulo específico sobre IA en la Ley de Derechos de Autor de Taiwán. Establecería una excepción para la minería de textos y datos, exigiría revelar las fuentes de entrenamiento y reduciría el riesgo de procesos penales para las actividades que cumplieran los requisitos.
La minería de textos y datos consiste en utilizar programas informáticos para analizar grandes cantidades de material e identificar patrones. La Unión Europea, Japón y Singapur contemplan excepciones para determinadas formas de esta actividad, aunque sus normas y condiciones difieren. Chen considera que esos enfoques pueden servir de referencia para el debate en Taiwán.
Lee propone un paso administrativo previo: publicar orientaciones que expliquen qué usos de entrenamiento consideran las autoridades legítimos y cuáles implican riesgos de infracción. Cita como ejemplo a la Agencia de Asuntos Culturales de Japón y su lista de verificación sobre derechos de autor e IA de 2024, junto con las orientaciones correspondientes, que ayudan a concretar las expectativas para desarrolladores y creadores.
Chen también sugiere establecer licencias colectivas, siguiendo el modelo de la Sociedad de Derechos de Autor Musical de China Taipéi, conocida como MÜST. En ese sistema, una organización gestiona los permisos de numerosos titulares, cobra las tarifas y distribuye los pagos. En el ámbito de la IA, un servicio similar podría reducir la tarea de negociar por separado con cientos de editoriales o autores.
Chang Chung-hsin, profesor adjunto del Instituto de Propiedad Intelectual de la Universidad Nacional de Tecnología de Taipéi, sostiene una postura distinta. Argumenta que los desarrolladores deberían pagar conforme a las normas vigentes sobre derechos de autor, en lugar de buscar cambios legales. Su propuesta sitúa el acceso negociado a contenidos editoriales y periodísticos valiosos en el centro de la solución.
TAIDE muestra por qué importan tanto el acceso como los recursos
El anterior motor de diálogo de IA confiable de Taiwán, o TAIDE, ilustra hasta qué punto un modelo puede depender de unas pocas colecciones accesibles. Creado como proyecto del Consejo Nacional de Ciencia y Tecnología a principios de 2023, recibió más de 200 millones de dólares taiwaneses para su desarrollo inicial.
TAIDE obtuvo materiales de entrenamiento de 15 organismos gubernamentales. Cerca de cuatro millones de artículos de la Agencia Central de Noticias representaban el 70 % de sus datos textuales. El material se obtuvo teniendo en cuenta los derechos de autor, lo que demuestra cómo el acceso organizado a grandes archivos periodísticos puede ayudar a desarrollar un modelo local.
El investigador principal, Yuh-Jye Lee, del Centro de Seguridad de la Información de Taiwán de la Academia Sínica, explicó el valor de contar con una alternativa nacional:
«Al principio, probablemente no podremos igualar a los grandes motores, pero contar con nuestro propio motor de diálogo significa que al menos tenemos una opción».
El primer modelo se basó en Llama 2, de Meta, y tenía 7.000 millones de parámetros, los valores numéricos que un modelo ajusta mientras aprende. El Centro Nacional de Computación de Alto Rendimiento contaba con 1.028 procesadores gráficos V100 y compró nueve procesadores H100 en noviembre de 2023 para el proyecto, a la vez que mantenía sus servicios habituales.
El proyecto de preguntas y respuestas agrícolas Demeter GPT de la Universidad Nacional Chung Hsing pasó más adelante de ChatGPT a TAIDE. Fan Yao-chung, profesor asociado, describió una mayor precisión en chino tras el entrenamiento adicional. Antes, el laboratorio pagaba a OpenAI entre 1 y 2 dólares taiwaneses por respuesta; al ejecutar TAIDE localmente, sus gastos operativos pasaron a depender de sus propios equipos y de la electricidad.
La iniciativa del corpus de Taiwán aborda el suministro de textos que sustenta aplicaciones como estas. Los diccionarios y registros culturales gubernamentales ofrecen una base. Un acceso más amplio a publicaciones, material docente especializado y periodismo dependerá de acuerdos que los desarrolladores puedan pagar y que los titulares de los contenidos estén dispuestos a aceptar.
Puntos clave
- Los colaboradores privados aportaron 111 de las 7.161 entradas del corpus, cerca del 1,6 %.
- En diciembre de 2025, el Gobierno anunció 600 millones de tokens al lanzar el corpus; en septiembre de 2026, el total superaba los 2.400 millones.
- La ministra Lin afirma que la participación privada es voluntaria y que los autores conservan la titularidad de los derechos de autor.
- El contenido periodístico queda fuera del programa actual de recopilación privada, mientras el ministerio busca acuerdos remunerados con empresas de IA.
- Una denuncia penal presentada en julio de 2025 por 140.000 artículos periodísticos no autorizados aumentó la preocupación de los desarrolladores independientes.
- Entre las propuestas figuran orientaciones más claras sobre el uso legítimo, una excepción para la minería de datos, licencias colectivas y pagos directos conforme a la legislación vigente.